새김 AI
프레임워크 없이 직접 구현한 개인 데이터 AI OS.
새김AI는?
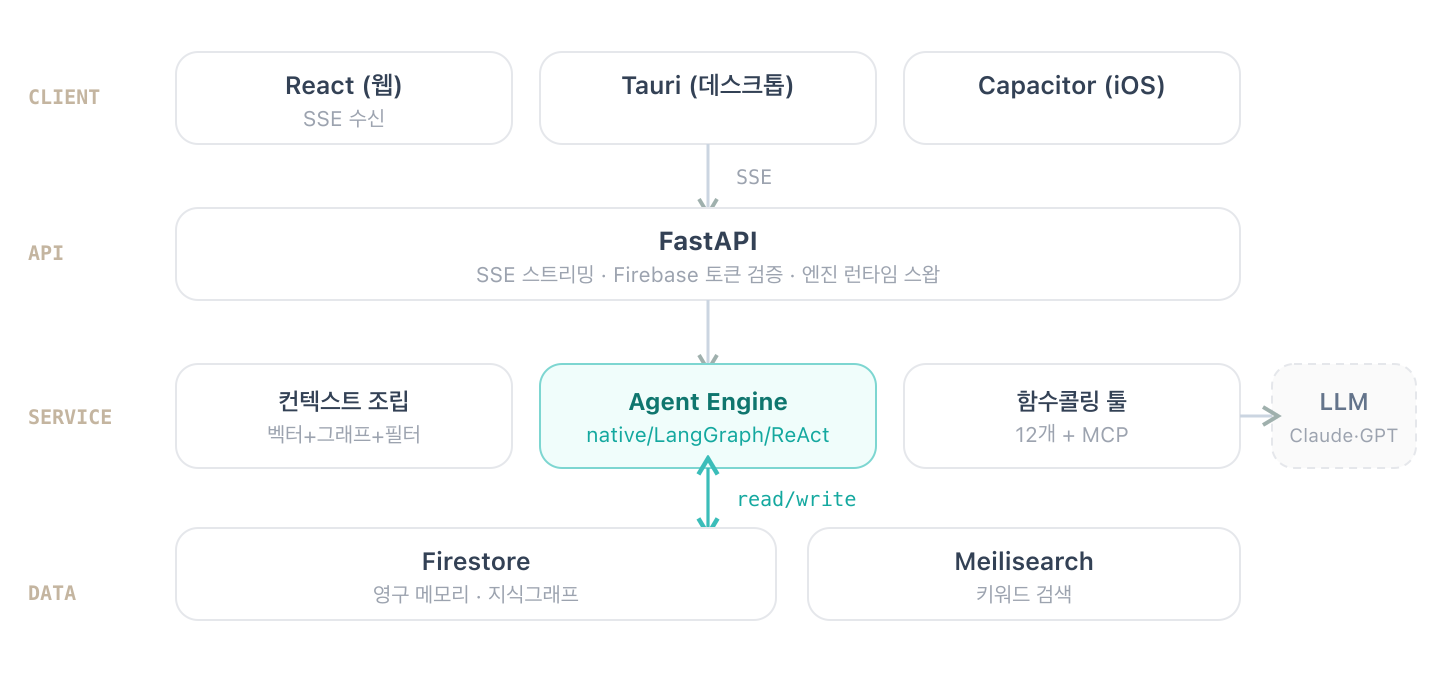
프레임워크에 기대지 않고 함수콜링·스트리밍·RAG·에이전트 루프를 프레임워크 없이 직접 구현한 "개인 데이터 AI OS"다. FastAPI 백엔드 위에 데스크톱(Tauri)·웹·iOS(Capacitor) 프론트가 붙고, 대화 중 12개 함수콜링 툴과 MCP 툴을 스스로 골라 호출한다.
제품으로는 실패했다. "모든 걸 넣어서 아무것도 아니게 된" 종료작(2026-04-09)이다. 이 위키가 자랑이 아니라 부검 소견이자, 거기서 뽑은 교훈인 이유다. 값진 건 남은 제품이 아니라, 이 프로젝트를 통과하며 손에 남은 기술과 판단이다.
왜 만들었나
일정은 구글캘린더, 메모는 노션, 지출은 뱅크샐러드에 흩어져 있었다. "다음 주 뭐 하지?" 하나에 앱을 세 개씩 열어야 했다. 그래서 "내 모든 데이터를 아는 AI를 직접 만들자"에서 시작했다(2025.10). AI의 응답이 텍스트로 끝나지 않고 실제 앱 동작으로 이어지게 하려고 OS식 UI를 택했다.
전체 구조
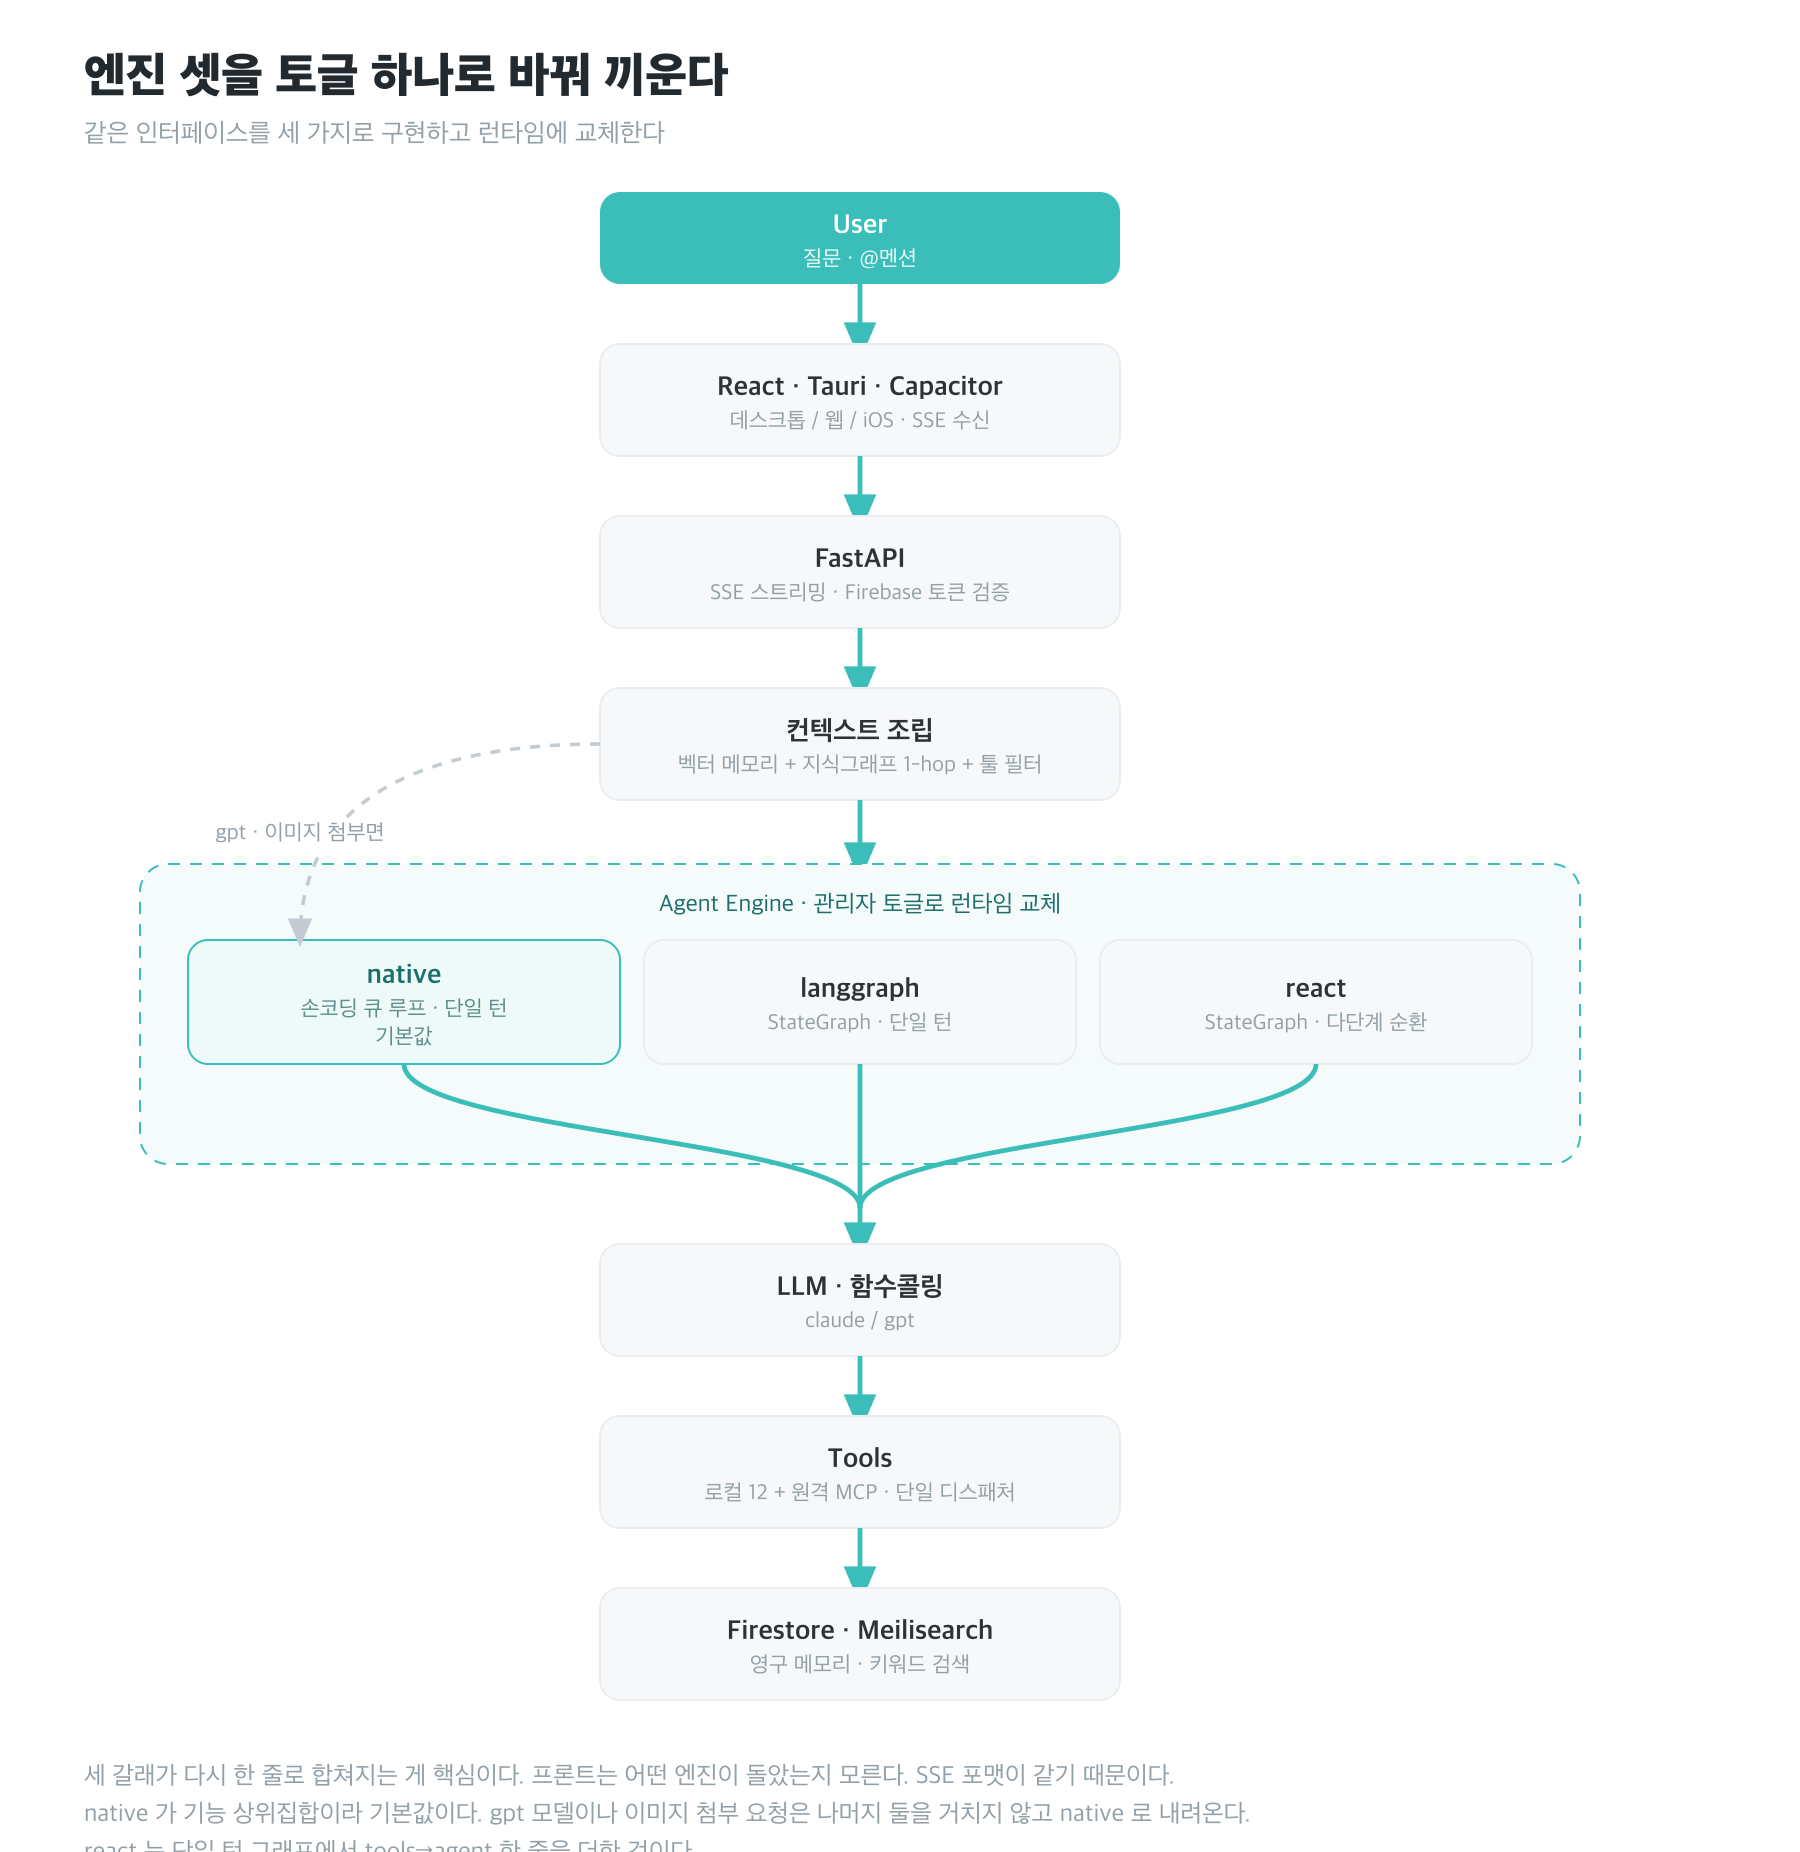
SSE 응답 포맷이 같아서 프론트는 어떤 추론 엔진이 돌았는지 모른다. 엔진 교체는 Firestore 설정값 하나로 런타임에 일어난다.
직접 구현한 에이전트 엔진
이 프로젝트에서 가장 공을 들인 부분이다. 에이전트 루프를 프레임워크 없이 직접 만들고, 같은 걸 LangGraph로 다시 만들어 나란히 비교했다. 이 엔진은 제품이 끝난 뒤(2026-04)에도 한참을 더 팠다. 기능을 늘리려던 게 아니라, 프레임워크가 감춰둔 원리를 직접 확인하고 싶어서였다.
native 루프 직접 구현
프레임워크 없이 Anthropic/OpenAI SDK로 직접 만든 단일 턴 툴콜 루프다. 새김의 툴은 그 자체로 완성형 답변을 반환하기 때문에(날씨 툴이 "오늘 서울은…" 문장까지 생성) 결과를 LLM에 되먹일 필요가 없다. 그래서 ReAct 순환이 아니라 단일 턴이 기본이다.
동기 SDK를 async 스트리밍에 태우려고 생산자(daemon 스레드)·소비자(async 제너레이터) 사이에 큐 브릿지를 뒀다. 텍스트 토큰은 생기는 대로 즉시 흘려보내고, 툴 호출은 스트림이 끝난 뒤 한 번씩 실행해 그 답변을 최종 답으로 내보낸다.
12개 함수콜링 툴
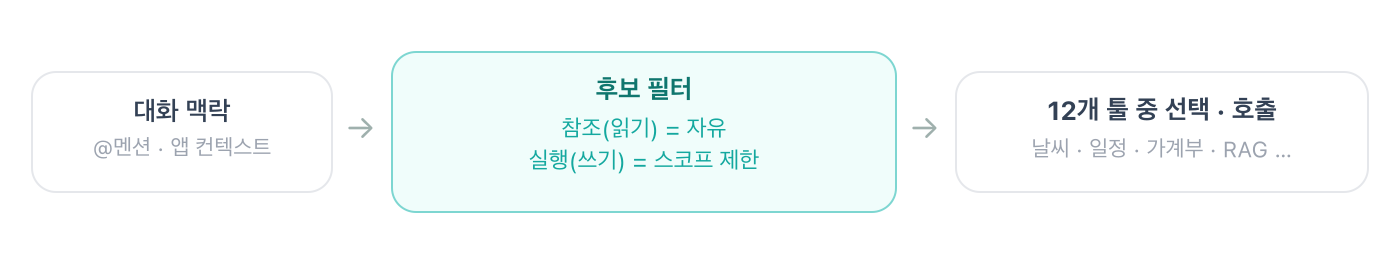
대화 맥락에 맞춰 아래 툴을 스스로 골라 호출한다. @멘션·앱 컨텍스트로 후보를 좁히고, "참조(읽기)는 자유, 실행(쓰기)은 스코프 제한" 원칙으로 필터한다.
| 툴 | 하는 일 |
|---|---|
get_weather | 현재·오늘·내일·주간·주말 날씨 (기상청 KMA) |
manage_schedule | 일정 등록·수정·조회 |
manage_ledger | 가계부 등록·요약·소비 브리핑·고정거래 |
search_user_data | 내 기록 RAG 검색 (+출처 뱃지) |
search_place | 주변 장소 (카카오 + 구글) |
search_my_places | 저장한 장소 검색 |
get_place_reviews | 구글 리뷰 AI 요약 |
web_search | 웹 검색 + 요약 (인라인 [n] 출처) |
create_document | 창작 문서 생성 (Canvas) |
generate_image | AI 이미지 생성·편집 |
play_music | 음악 검색·재생 |
translate | 번역 |
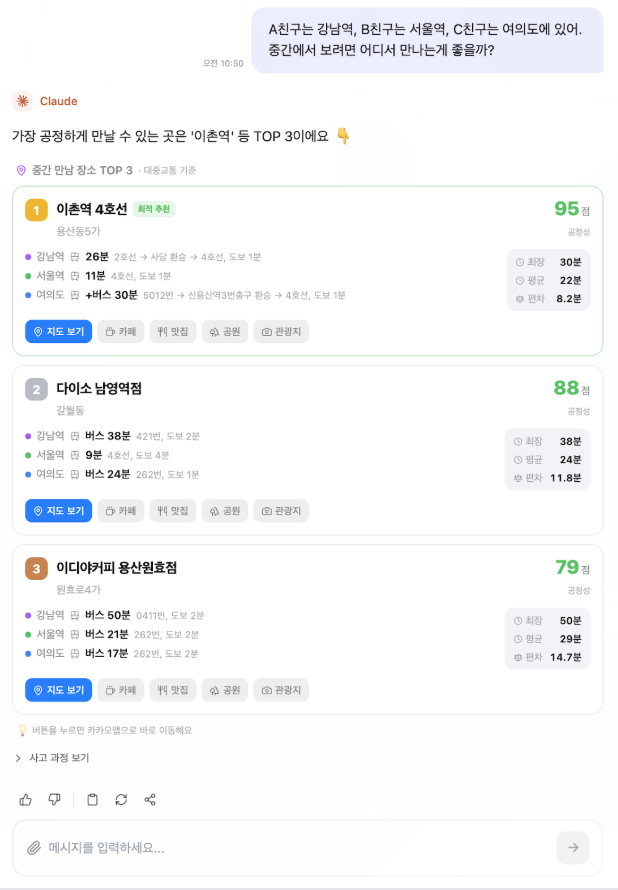
find_meeting_point (MCP) | 그어봄이 찾는 공정한 중간지점 |
native ↔ LangGraph ↔ ReAct
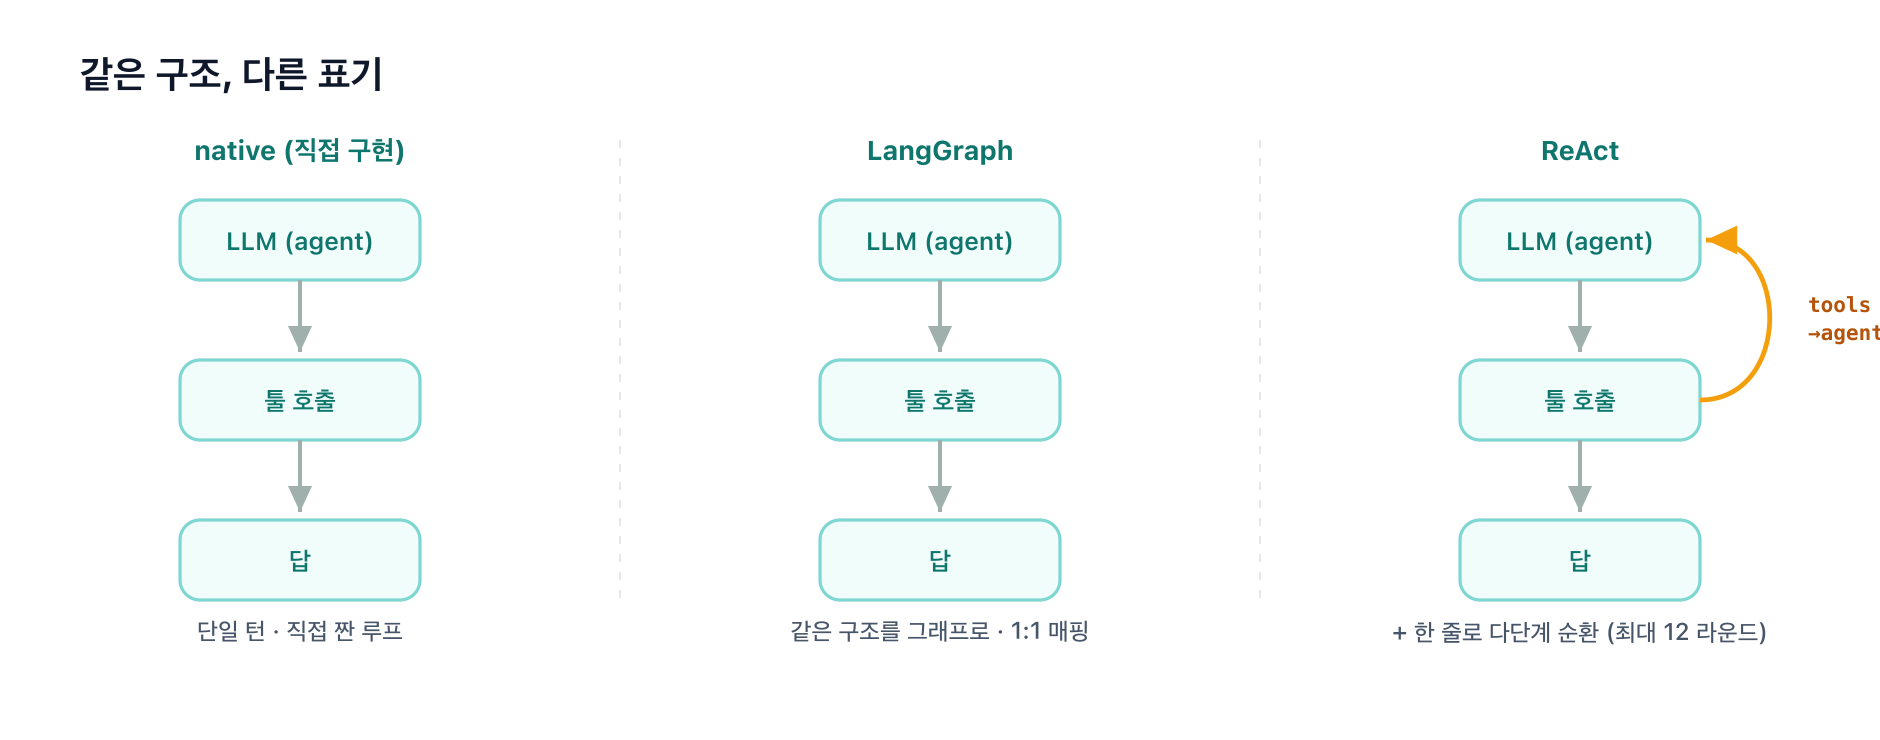
관리자 토글 하나로 추론 엔진 3종을 런타임 교체한다. 목적은 "프레임워크는 마법이 아니라 도구"를 동등 구현으로 증명하는 것. LangGraph 그래프는 직접 구현한 루프와 1:1로 매핑되고, ReAct 엔진은 그 그래프에서 단 한 줄(tools→agent) 차이로 다단계 순환이 된다.
둘 다 만들어보고 native를 기본으로 채택했다. 근거:
| 축 | native (직접 구현) | LangGraph |
|---|---|---|
| 프로바이더 | claude + gpt 모두 | claude 전용 (gpt는 native 폴백) |
| 첨부(이미지) | 지원 | 미지원 → native 폴백 |
| 프롬프트 캐싱 | Anthropic ephemeral 적용 | 미적용 (토큰 비용↑) |
| 스트리밍 제어 | 저수준 직접 (Railway 우회 가능) | astream 추상화 의존 |
| 상태/메모리 | Firestore가 담당 | MemorySaver 제공하나 미주입 (Firestore가 이미 함) |
| 확장 | 루프 직접 수정 | ReAct로 한 줄 확장 |
native가 기능이 더 넓고(gpt·첨부까지 커버), 프롬프트 캐싱으로 더 싸고, 스트리밍 저수준 제어가 필요했고, 프레임워크가 주는 상태관리는 이미 Firestore가 하고 있어 더 얹을 게 없었다. 그럼에도 LangGraph를 옵션으로 남긴 건 선언적 구조와 ReAct 한 줄 확장의 학습·소통 가치 때문이다.
ReAct 엔진은 최대 12번까지 순환하고, 최종 답은 라운드 수로 가른다. 툴을 안 부르면 바로 답하고, 한 번만 부르면 그 툴 답을 원문 그대로 살려 출처를 보존하고, 여러 번 체이닝할 때만 종합한다.
멀티프로바이더 추상화
model="claude" | "gpt" 문자열 하나로 두 프로바이더를 통합했다. Claude Tool Use를 기준으로 양방향 스키마 변환을 두고, tool_choice 방식 차이와 tool_calls 파싱 차이(Claude는 인자가 이미 객체, OpenAI는 JSON 문자열)를 경계에서 흡수해 결과를 하나의 타입으로 통일한다.
SSE 스트리밍 (Railway 우회)
모든 SSE 이벤트에 ~1KB 공백 패딩을 붙인다. Railway 프록시가 작은 청크를 버퍼링해 스트리밍이 끊기는 걸 우회하기 위한 것이다. 이벤트를 token·thinking·step·rich_card·sources로 구분해 프론트가 각각 다르게 렌더한다.
임베딩 RAG + 출처 그라운딩
text-embedding-3-small(1536차원)로 게시글·일정·일기를 임베딩한다. 처음엔 청킹 없이 문서 하나를 벡터 하나로 만들어 Firestore에 인라인 저장하고, 검색은 전량 브루트포스 코사인으로 했다. 개인 데이터 규모엔 전용 벡터DB나 ANN이 필요 없다는 판단이었다. 검색된 근거는 응답에 출처 뱃지로 붙는다.
이후 오버랩 청커를 얹어 2000자를 넘는 장문도 뒷부분까지 검색되게 했다. 짧은 개인 기록엔 청킹이 필요 없었지만, 문서 첨부 기능이 청커를 불렀다. 규모가 커지며 설계가 따라 진화한 셈이다.
이 검색 경로는 지금도 채점당하고 있다. saegim-eval이 매일 돌면서 모형 파이프라인이 아니라 이 백엔드의 청킹·임베딩·랭킹 함수를 그대로 불러 검색 품질을 잰다. 그래서 청크 크기나 임베딩 모델을 건드리면 다음 날 점수로 드러난다. 종료한 프로젝트의 엔진이 다음 프로젝트의 측정 대상으로 남은 셈이다.
GraphRAG (지식그래프)
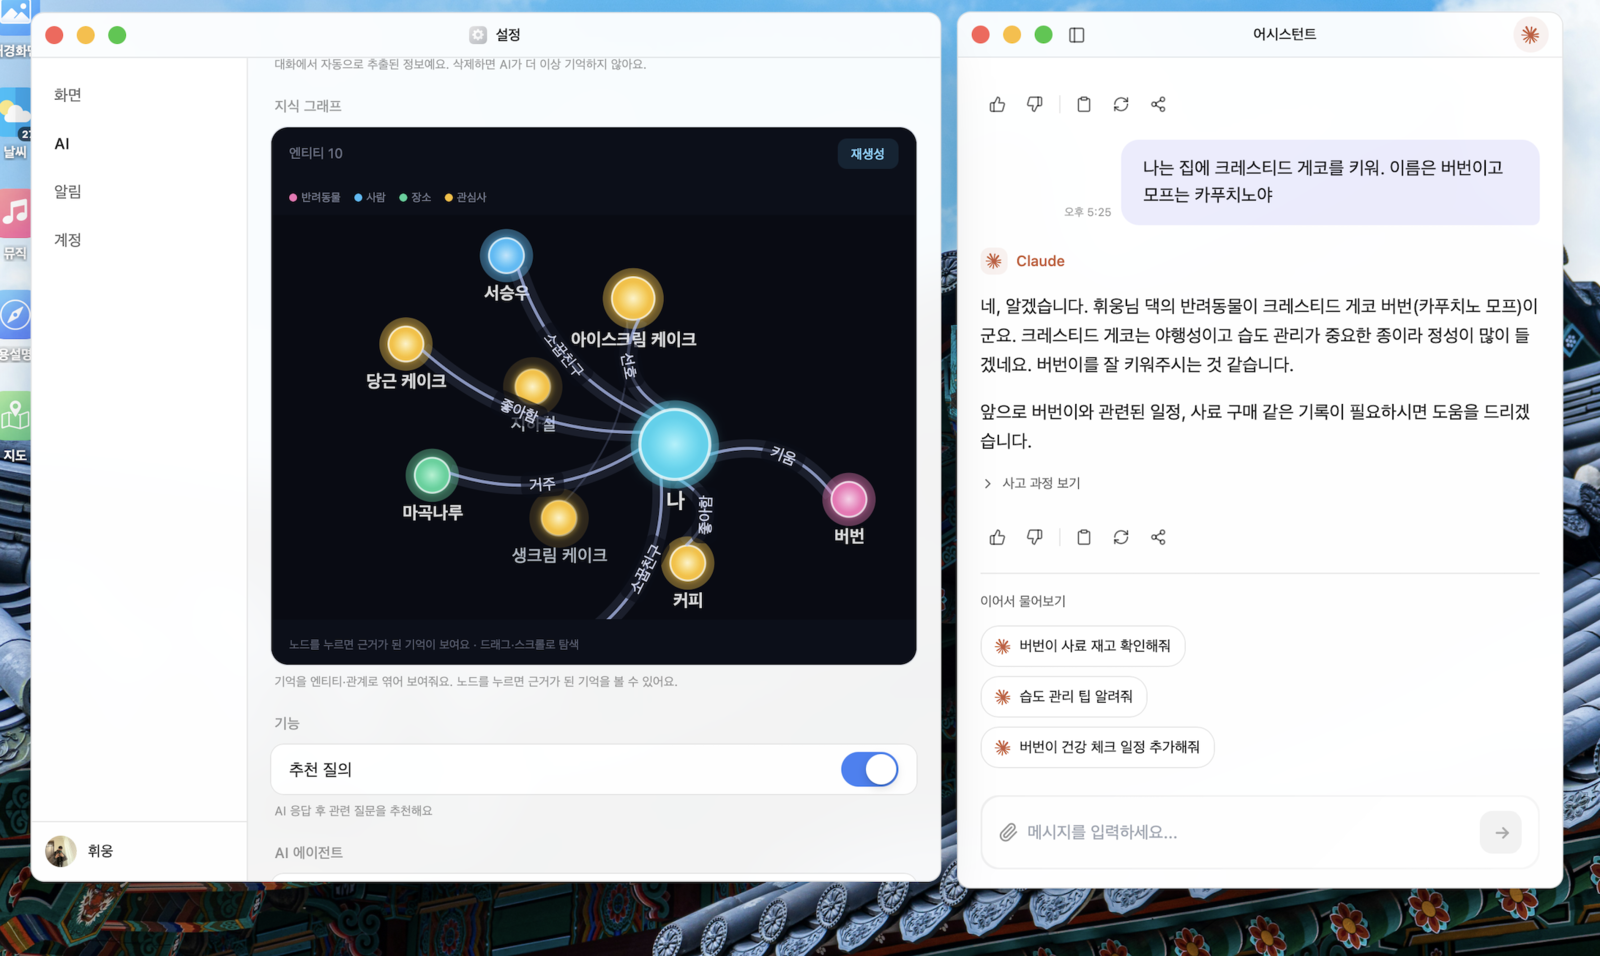
납작하게 쌓인 메모리에서 사람·장소·프로젝트·관심사 같은 엔티티 8종과 그 관계를 뽑아 "AI가 아는 나" 그래프를 만든다. 질의가 들어오면 이름을 그래프 노드와 매칭(LLM 호출 없이)해 한 홉 이웃까지 훑어 근거 기억을 주입한다.
처음엔 그래프를 그리기만 하고 질의에 참조하지 않아서 "시각화지 GraphRAG가 아니었다." 엔티티 링킹→서브그래프 주입을 붙이고 나서야 이름값을 했다. 말만 GraphRAG였던 걸 스스로 바로잡은 셈이다.
대화 메모리 + dedup
지속적인 사실만 추출해 저장한다. 가계부 금액이나 일회성 일정 같은 건 일부러 뺀다. 중복은 두 단계로 거른다: 텍스트가 똑같으면 버리고, 임베딩이 아주 비슷하면 새 것으로 교체한다.
MCP 호스트
새김 백엔드를 MCP 호스트로 만들어 원격 MCP 툴을 내부 툴에 머지한다. v1은 그어봄 하나(카카오 PlayMCP, Streamable HTTP 전송). 중간지점 결과는 전용 카드로 승격해 렌더한다.
여기까지가 남의 도구를 불러 쓰는 쪽이다. 나중에 같은 백엔드가 남이 붙어 쓰는 쪽도 됐는데, 그 이야기는 아래 "이제 한 줄로 준다"에 있다.
끝난 제품, 계속 쓰이는 배관
제품은 2026년 4월에 끝났다. 그런데 백엔드는 8월부터 다시 손을 봤다. 기능을 늘리려던 게 아니라, 다른 제품이 이 검색 엔진을 갖다 쓰기 시작해서다. 새로 만든 사내 도구(새김 웍스)의 자료 방이 파일을 올리면, 색인과 검색은 이 백엔드가 한다. 프론트도 데스크톱 앱도 커밋 한 줄 늘지 않았다. 처음 늘어난 건 API 넷뿐이었다.
경계를 이렇게 그었다. 원본 파일과 권한과 화면은 부르는 제품이 갖고, 색인은 여기가 갖는다. 부르는 쪽 코드에는 "벡터"라는 말이 한 번도 나오지 않는다. 임베딩 모델이나 청크 크기를 바꾸면 색인을 전량 다시 만들어야 하는데, 제품마다 색인을 들고 있으면 그때 제품을 하나씩 찾아다녀야 하기 때문이다. 그렇다고 묶이는 것도 아니다. 원본이 제품에 남아 있으니 파이프라인을 갈아끼우고 다시 색인하면 그만이다.
2만 자에서 잘리던 천장
원래 청킹 함수는 청크 스무 개에서 스스로 멈췄다. 청크를 문서 하나에 전부 담는 구조라 저장소 문서 크기 한도가 곧 본문 길이 한도였고, 실측하면 2만 자쯤에서 뒷부분이 사라졌다. 공용 색인은 청크 하나를 문서 하나로 저장하니 그 전제가 없다. 기존 함수는 그대로 두고 위에 조립 계층만 얹었다. 본문을 창으로 잘라 창마다 돌리고 이어 붙인다.
첫 판은 잘못 만들었다. 소비한 글자 수를 마지막 청크의 위치로 되짚었는데, 슬라이드나 표처럼 같은 문단이 반복되는 문서에서 뒤쪽의 같은 문자열을 잡았다. 4만 2천 자 문서가 청크 스무 개로 "전량 색인 완료"라고 보고했다. 조용한 손실이라 실측하지 않으면 영영 몰랐을 종류다. 지금은 창을 미리 잘라 두어 소비량을 추측할 필요가 없고, 그래도 상한에 걸리면 응답에 잘렸다고 적어 보낸다.
유사도 임계값을 버렸다
11장짜리 사업 제안 장표를 색인하고 질문 다섯 개를 던져 봤다. 배관은 도는데 답이 이상했다.
| 질문 | 결과 |
|---|---|
| 이사는 언제 하기로 했나 | 정답 문서가 0.276. 임계값 0.3에 잘림 |
| 점심 메뉴 추천 | 관계없는 그림이 0.361로 통과 |
| 회의실 부족 문제 | 본문 청크가 같은 문서의 캡션 청크보다 낮음 |
코사인 값의 절대 크기는 질의 길이와 청크 길이에 좌우된다. 짧은 한국어 질의는 통째로 낮게 나오고, 짧고 빽빽한 이미지 캡션은 아무 질문에나 중간값이 나온다. 어느 숫자를 박아도 같은 사고가 난다는 뜻이다. 그래서 임계값을 0으로 내리고 점수를 그대로 실어 보낸다. 관계가 있느냐는 판정은 점수 하나가 아니라 근거를 보고 한다.
청크는 1200자에서 400자로 줄였다. 1200자면 슬라이드 대여섯 장이 한 덩어리라, 그 안의 한 문장으로 물으면 나머지가 신호를 희석한다. 그리고 뜻으로 찾는 것과 별개로 키워드 검색을 붙였다. 문서에 그 글자 그대로 있는 드문 낱말은 벡터가 아니라 키워드의 일이다. 한글은 형태소 분석기 없이 글자 2-gram으로 자르고, 두 결과는 점수를 더하지 않고 순위로 합친다(RRF). 절대값은 못 믿어도 순위는 믿을 수 있다는 게 그날 얻은 결론이다. 응답에는 벡터 점수와 키워드 점수를 같이 실어, 어느 갈래가 잡았는지 보이게 했다.
지어내면 못 쓰는 기능
색인에서 근거를 뽑아 답하는 엔드포인트를 붙이면서 가장 신경 쓴 건 답을 잘 하는 게 아니라 못 할 때 답하지 않는 것이었다. 한 번 지어낸 답을 보면 그다음부터 전부 의심하게 되고, 의심하며 쓸 바에는 파일을 직접 여는 게 빠르다.
부르기 전에 근거의 세기를 잰다. 그 말이 문서에 글자 그대로 걸렸거나, 없더라도 뜻이 충분히 가깝거나. 답을 못 냈을 때는 오류 대신 이유를 돌려준다. 근거가 없어서 못 답한 것과 근거는 찾았는데 답을 못 만든 것은 화면에서 달라야 해서, 뒤엣것은 읽을 대목을 같이 넘긴다.
출처는 모델 말을 믿지 않는다. 실측에서 모델이 답은 맞게 하고 출처는 틀리게 적었다. 금액을 정확히 답해 놓고 근거로는 도입부 슬라이드를 가리켰는데, 그 조각에 그 숫자가 없었다. 뒷받침하지 않는 출처는 출처가 없는 것보다 나쁘다. 검증된 것처럼 보이기 때문이다. 그래서 번호 대신 원문 인용구를 받는다. 모델이 근거마다 원문 그대로의 대목을 옮겨 적으면, 그 글자가 실제로 어느 조각에 있는지 코드가 찾는다. 번호는 검증할 수 없지만 글자는 검증할 수 있다. 인용구가 원문에 없으면 지어낸 것으로 보고 답을 내보내지 않는다.
겹쳐 쌓은 방어를 하나 걷어냈다
방어를 하나 더 두고 있었다. 그림 캡션만 걸린 질문에는 아예 답하지 않는 규칙이었다. 캡션은 그림 묘사지 사실 진술이 아니니, 거기서 예산 숫자를 뽑는 걸 막자는 것이었다.
그런데 "테라리아컨셉 이미지 어디 있나"에 못 답했다. 그림은 캡션밖에 없다. 그림에 대한 질문을 구조적으로 막고 있었던 셈이다. 게다가 그 방어는 중복이었다. 나중에 붙인 인용구 검증이 같은 일을 더 정확하게 한다. 캡션에 예산 숫자가 없으면 모델은 그 숫자를 인용할 수 없고, 인용을 못 하면 답이 안 나간다. 방어를 둘 두느라 되는 것까지 막고 있었다.
원인이 하나 더 있었다. 캡션 청크에 캡션과 태그만 넣어서 "테라리아컨셉"이라는 글자가 색인 어디에도 없었다. 사람은 파일을 이름으로 기억하는데, 캡션은 AI가 쓴 글이라 사용자가 아는 말과 다르다. 이름과 분류를 색인에 같이 넣었다. 둘 다 내가 만든 제약이었다는 게 이 건의 요지다.
문서 검색기에서 어시스턴트로
"안녕?"에도 "자원 방 문서 1건을 뒤졌지만 근거가 될 대목이 없었습니다"라고 답했다. 어시스턴트인데 문서 검색기로 굴러가고 있었다.
"근거 없으면 답하지 않는다"는 회사 안 사실을 물었을 때만 맞는 규칙이다. 인사와 일반 지식에까지 걸면 아무것도 못 하는 물건이 된다. 그래서 검색 도구를 하나 쥐여주고 부를지 말지를 모델이 정하게 했다. 부르면 근거와 출처가 따라오고, 안 부르면 그냥 답한다. 그때는 출처가 없는 게 맞다. 대신 회사 안 사실은 자기 지식으로 답하지 말고 반드시 찾아보라고 못 박았다.
방도 하나로 묶지 않았다. "디자인팀 김철수 전화번호"는 조직 색인에 있고 "판교 이전 비용"은 자료 색인에 있는데, 사용자는 그 구분을 모르고 묻는다. 볼 수 있는 색인을 한꺼번에 뒤진다. 키워드 색인은 합친 코퍼스 하나로 만든다. 색인마다 따로 만들면 희소도 기준이 달라져 점수를 나란히 놓을 수 없다.
되묻는 질문도 처리해야 했다. "그럼 그 사람 자리는?"을 그대로 임베딩하면 아무것도 안 걸린다. 그 문장에 찾을 낱말이 하나도 없기 때문이다. 앞 대화를 보고 혼자 뜻이 통하는 검색어로 다시 쓴 뒤에 찾는다. 재작성이 실패하거나 장황해지면 원문을 쓴다.
부르는 쪽에는 끝까지 청크 이야기를 안 한다. 그림 두 장에 「본문」 배지가 붙는 사고가 났을 때도, 부르는 쪽이 청크 번호로 판단하게 두는 대신 서버가 판정해서 제품이 쓰는 말로 실어 보냈다. 본문에 걸렸는지 AI 설명에 걸렸는지. 경계를 그어놓고 편할 때만 넘어가면 그건 경계가 아니다.
사람이 로그인해야만 부를 수 있었다
여기까지는 부르는 쪽이 하나였다. 웍스가 사람 로그인으로 받은 토큰을 그대로 넘겼고, 엔진은 그 토큰만 받았다. 그런데 그 값은 사람이 브라우저에서 로그인해야만 생긴다. 서버에서 돌 배치도, 편집기에 붙일 도구도, 다른 앱도 전부 문 앞에서 막혔다.
그래서 기계용 자격을 따로 냈다. sgk_<id>.<secret> 꼴이고, 앞에 붙은 id로 저장소 문서 하나만 찾는다. 비밀만 들고 다니면 검증할 때마다 키를 전량 훑어야 하고 키가 늘수록 느려진다. 저장은 해시만 하고 원문은 발급 응답이 유일한 사본이다. 비교는 상수 시간으로 한다. 평범한 문자열 비교는 몇 글자가 맞았는지를 응답 시간에 남긴다.
헤더는 사람용과 기계용을 나눴다. 같은 자리에 둘을 얹고 접두사로 가르는 방법도 있었지만, 그러면 판정이 문자열 모양에 의존한다. 언젠가 모양이 겹치는 값이 오면 조용히 엉뚱한 검증기로 간다. 헤더가 다르면 그 판정 자체가 없다. 그리고 키를 발급하는 창구만 사람 전용으로 뒀다. 키로 키를 만들 수 있으면, 검색만 하라고 준 키가 자기보다 센 키를 발급해서 제한을 벗어난다.
콜드 스타트인 줄 알았던 97초
콘솔에서 첫 호출이 97초 걸렸다. 서버가 자다 깨는 시간으로 보였다.
아니었다. 끝난 제품 쪽 인증 자격이 만료돼 있었는데, 그걸 쓰는 호출이 5분을 재시도하고 있었다. 그 호출이 블로킹인데 async 배치 안에 있어서 이벤트 루프를 통째로 막았다. 주기가 1분이라 앞 것이 안 끝난 채로 계속 겹쳤다. 새 API가 느린 게 아니라, 밑에 깔린 옛 배관이 죽으면서 위를 눌러앉힌 것이다. 끝난 제품의 배치를 기본으로 끄는 스위치를 두고 코드는 남겼다.
앞서 색인이 403으로 죽었던 것도 같은 뿌리였다. 종료작 위에 새 배관을 얹으면, 옛 것이 죽을 때 증상이 새 것에서 평범한 얼굴로 나타난다.
이름이 거짓말을 하고 있었다
점수 하한 필드 이름이 minScore였다. 그런데 응답에 실리는 최종 점수는 순위를 합친 값이라 최대가 0.033 언저리다. 0.0156짜리 결과에 0.02를 걸어봤는데 그대로 통과했다. 그 값이 실제로 걸리는 자리는 벡터 점수였기 때문이다. 이름을 minVectorScore로 바꿨다. 응답에 같이 실어 보내는 벡터 점수와 같은 자다. 순위 쪽에는 하한을 아예 안 만들었다. 절대값에 뜻이 없다고 정해놓고 그 값을 자르는 문을 만들면 앞의 결정을 스스로 무르는 것이다.
각자 올린 자료를 각자만 보게
색인 하나를 여럿이 쓰게 되자 칸막이가 필요해졌다. 그전까지는 라우터가 요청 본문에 실려 온 범위 표식을 그대로 믿었다. 부르는 쪽이 자기 범위를 스스로 선언하는 구조는 칸막이가 아니다. 표식을 신원에서 꺼내 쓰게 바꾸고, 색인하는 자료마다 주인을 박았다.
여기서 읽기와 쓰기가 갈렸다. 같은 목록이라도 읽기에서는 "이만큼까지 보겠다"이고 쓰기에서는 "이만큼에게 보여주겠다"다. 그래서 비었을 때 안전한 답이 정반대다. 읽기에서 가진 것 전부는 가장 넓게 보겠다는 뜻이라 안전하고, 쓰기에서 같은 규칙은 내 표식 전부에게 공개한다는 뜻이 된다. 쓰기는 안 밝히면 거절한다.
배포에서 걸린 건 열려 있던 탭이었다. 웍스를 새로 올려도 이미 열려 있는 화면은 옛 번들이고, 옛 번들은 전원이 가진 옛 표식을 보낸다. 호출자가 실제로 그 표식을 가지므로 검사만으로는 통과하고, 그러면 전원에게 보이는 자료가 조용히 생긴 뒤로 아무에게도 주인이 없다. 쓰기에서 옛 표식을 아예 빼서 눈에 띄게 실패하게 했다. 조용히 새는 것보다 낫다. 읽기에서는 남겼다. 옮기다 빠진 게 있으면 그 자료가 조용히 사라지기 때문이다.
이제 한 줄로 준다
마지막은 붙는 규격이었다. 같은 백엔드에 MCP 서버를 얹었다. 새 패키지는 안 넣었다. 원격 도구를 불러 쓰려고 이미 들여둔 그 라이브러리의 서버 쪽을 쓴다. 설치도 저장소도 없이 이 한 줄이면 남에게 준다.
claude mcp add --transport http saegim https://api.saegim.studio/mcp \
  --header "X-Saegim-Key: <발급한 키>"
도구는 검색과 답변 둘, 둘 다 읽기 전용이다. 색인이나 삭제 도구는 안 냈다.
세션을 안 든다. 세션을 들면 처음 한 번의 자격이 그 뒤 호출 전부에 계속 쓰여서, 키를 폐기해도 살아 있는 세션은 안 죽는다. 요청마다 다시 검증하면 그 문제가 없고, 인스턴스가 여럿이거나 재시작해도 끊기지 않는다.
사람 토큰은 일부러 안 받는다. 로그인 토큰은 한 시간이면 만료되므로 설정 파일에 적어 둘 수 있는 값이 아니다. 받아 주면 "되는 것처럼 보이다가 한 시간 뒤 죽는" 설정이 생긴다.
붙이면서 실측으로만 걸러진 것이 둘 있었다. 마운트로 붙이면 /mcp 정확히에는 안 걸리고 끝에 빗금이 붙은 주소에만 걸려서, 호출이 리다이렉트로 답한다. 클라이언트가 그걸 따라가는지에 운을 걸게 된다. 그리고 레이트리밋 미들웨어가 매 요청마다 처리 함수의 이름을 읽는데, 여기 붙은 건 함수가 아니라 앱이라 이름이 없어서 500이 났다. 둘 다 코드로는 멀쩡해 보이는 종류다.
같이 지운 것도 있다. 따로 만들어 뒀던 로컬 전용 MCP 서버는 통째로 지웠다. HTTP 쪽이 같은 도구를 같은 인가로 내놓기 때문이다. 지우기 전에 두 파일의 도구 설명을 코드에서 뽑아 대조해, 안 옮겨진 문장이 없는지부터 확인했다.
넣고 나서야 알았다
색인에 자료가 세 건뿐이라 물어볼 거리가 없었다. 그래서 개발일지 62건을 밀어 넣었다. 검색해 보니 스니펫이 커밋 해시 나열이었다. 그날 무엇을 했나의 기록이라 읽을 문장이 아니라 목록이었던 것이다.
위키를 밀어 넣었다. 프로젝트가 무엇이고 왜 그렇게 정했는지가 문장으로 있어서 "이거 왜 이렇게 했더라"에 답이 된다. 49건. 뉴스는 뺐다. 남이 쓴 기사를 모아둔 것이라, 섞이면 자기 것을 찾을 때 남의 기사가 같이 올라와 색인이 오염된다. 개발일지도 색인에는 그대로 남아서, 지금은 둘이 「프로젝트」라는 한 묶음으로 같이 검색된다.
넣는 김에 하나를 지워보다 걸렸다. 이름에 빗금이 든 문서는 삭제 주소에 아예 안 걸려서 404가 났다. 인코딩해도 같았다. 색인 쪽은 이름을 본문으로 받아 멀쩡했고 삭제만 막혀 있었다. 그대로 뒀으면 이미 넣은 49건이 영영 못 지우는 고아가 됐다.
왜 이게 근거가 아닌지
답이 이상할 때 물어볼 곳이 없었다. 근거로 선 조각만 돌려주니 빠진 게 문턱 때문인지 개수 제한 때문인지 알 수 없었다. 미는 손잡이가 다른데 화면에서는 똑같이 "없음"으로 보였다.
그래서 떨어진 후보를 사유와 함께 같이 싣는다. 문턱을 못 넘었으면 문턱을 낮추라는 뜻이고, 개수에 밀렸으면 개수를 올리라는 뜻이다. 그 손잡이 넷도 요청에서 받게 열었다. 안 보내면 서버 기본값 그대로라 기존 호출자는 한 글자도 안 바뀐다.
근거 카드에 점수를 붙였는데 하나는 일부러 숫자로 안 보인다. 키워드 점수는 상한이 없어서 "유사도 4.32"처럼 보이면 0에서 1 사이로 읽는 사람에게 거짓말이 된다. 대신 그 값이 0일 때만 「뜻으로만」이라고 한 마디 세운다. 근거로 인정하는 규칙이 "그 말이 문서에 있거나, 없어도 뜻이 가깝거나"라서, 키워드가 0인 근거는 그 낱말이 문서에 아예 없었고 뜻으로만 걸린 것이다. 그게 "왜 이게 근거지"의 답이다.
배관에서 발행 판으로
자료를 목적별로 묶는 축을 만들었다. 지식베이스다. 권한 표식에 얹지 않았다. 누가 볼 수 있느냐와 무엇을 위해 모았느냐는 다른 축이고, 같이 굴리면 둘 다 망가진다. 묶음을 지워도 자료는 안 지워진다. 이름표만 걷어낼 뿐이라 검색에는 그대로 걸린다.
사용자가 고르는 것도 바꿨다. 전에는 「검색 대상」에서 색인을 골랐는데, 이 답이 위키에 있는지 개발일지에 있는지는 묻는 사람이 알 수 없다. 알 수 없는 것을 고르게 두면 매번 틀린다. 이제 지식베이스만 고른다.
묶음에 이름과 지침과 파라미터를 붙여 저장한 것이 앱이다. 앱마다 MCP 주소가 따로 나가고 도구 이름과 설명도 앱마다 다르다.
claude mcp add --transport http barista \
  https://api.saegim.studio/api/v1/rag/mcp/barista \
  --header "X-Saegim-Key: <발급한 키>"
여기서 둘을 못 박았다. 하나는 MCP 인스턴스를 앱마다 안 만드는 것이다. 세션 관리자는 서버가 뜰 때 열리는데 앱은 사용자가 나중에 만든다. 앱마다 인스턴스를 만들면 서버가 뜬 뒤에 생긴 앱은 열어 줄 사람이 없어 첫 호출에서 죽는다. 한 번 밟은 함정이라 인스턴스는 하나로 두고 도구 목록만 요청마다 갈아 끼운다.
다른 하나는 앱 도구가 범위 인자를 안 받는 것이다. 검색어만 받는다. 범위를 정하는 것은 앱이지 부르는 모델이 아니다. 열어 두면 모델이 넓혀 부르고, 원두만 보라고 만든 바리스타가 아무거나 답하기 시작한다.
아무도 안 부르는 문
만들고 나서 「프로젝트」 지식베이스를 골라 검색했더니 0건이었다. 위키와 개발일지는 지식베이스가 생기기 전에 색인돼서 묶음 표식이 비어 있었다. 소급해 채우는 엔드포인트를 만들어는 뒀는데 아무도 부르지 않았다.
아무도 안 부르는 문은 안 만든 것과 같다. 문을 걷어내고, 목록을 조회할 때 서버가 도장을 확인해 없으면 응답을 보낸 뒤에 알아서 쓸어 담게 했다. 도장은 일이 끝난 뒤에 찍는다. 먼저 찍으면 한 번 실패한 사람이 영영 못 받는다. 생성 시점을 방아쇠로 쓰지도 않았다. 지금 0건인 사람은 문서가 이미 있고 표식만 안 붙은 상태라 그 방아쇠에는 영영 안 걸린다.
그리고 열흘 뒤에 그걸 걷어냈다. 도장을 찍는 쓰기가 할당량 초과로 실패하면, 다음 요청이 또 도장이 없다고 판단해 또 300건을 읽는다. 할당량이 모자라서 실패한 일이 할당량을 더 먹는 되먹임이었고, 그날이 정확히 그 상태였다. 「도장은 일이 끝난 뒤에 찍는다」가 그 조건이었던 셈이다. 소급 함수는 스크립트용으로 남기고 함수 주석에 「다시 조회 경로에 달지 마라」를 박았다. 아무도 안 부르는 문이 쓸모없는 건 맞지만, 평소 경로에 일을 얹으면 그 일이 실패할 때도 평소 경로에서 실패한다. 이건 앞의 판단을 무른 게 아니라 값을 치른 것이다.
처음으로 사람이 눌렀다
여기까지 만든 건 전부 타입 검사와 빌드와 테스트를 통과한 코드였다. 그 위에서 사흘 동안 넷이 터졌다.
앱은 한 번도 발행된 적이 없었다
지침을 안 적고 발행하면 늘 422였다. 화면은 빈 문자열을 보내는데 서버 모델에 최소 길이 1이 걸려 있었다. 답변 요청 스키마에서 그대로 베껴 온 제약인데, 앱에서 빈 지침은 「서버 기본을 쓰겠다」는 뜻이 있는 값이다. 저장소는 이미 그렇게 읽고 있었고 서버 모델만 혼자 거절했다. 고치기 화면에 적힌 「비우면 서버 기본으로 돌아갑니다」도 같이 거짓말이었다.
앱이 0개였던 게 아니라 만들 수가 없었고, 그래서 앱을 고르는 줄도 영영 안 떴다. 사흘 뒤 한 줄 설명 필드를 붙이면서 같은 사고를 막으려고 네 곳에 같은 문장을 박고, 그중 한 곳에는 「여기에 빈 설명은 뺀다를 넣지 마라」까지 적었다. 다음 사람이 선의로 되살릴 자리라서다. 덤으로 화면에 「422」 석 자만 뜨던 것을 사람 말로 바꿨다. 422는 사용자가 고칠 수 있는 게 아니라 배선이 틀렸다는 뜻이라, 「다시 해 보세요」로 넘기면 영영 안 고쳐진다.
첫 PDF는 저장에서 터졌다
파싱도 임베딩도 다 성공하고 마지막에 「트랜잭션이 너무 큽니다」가 났다. 돈이 나간 뒤에 통째로 버려진 것이다.
문서가 커서인 줄 알았는데 4만 자를 재현해서 재 보니 페이로드는 상한의 26%였다. 터진 건 문서가 아니라 색인 항목이었다. 1536차원 벡터가 배열이라 원소 수만큼 색인 항목이 생긴다. 청크 하나가 1,562개고 149개면 23만 개, 항목당 64바이트로만 쳐도 14MiB다. 그래서 배치를 개수가 아니라 무게로 끊는다. 무게에 색인 항목 수를 곱해 넣고, 어림은 실측보다 늘 크게 나오도록 맞췄다(무작위 3천 건에서 과소평가 0건).
진짜 해법은 벡터 필드를 색인에서 빼는 것이다. 그 벡터로 질의하지 않는다. 나가는 질의는 세 필드뿐이고 랭킹은 파이썬이 한다. 빼면 문서당 색인 항목이 1,562에서 26으로 준다. 그런데 그건 코드가 아니라 저장소 콘솔에서 하는 일이라, 코드 쪽 스위치는 일부러 꺼진 채로 뒀다. 콘솔에 안 걸고 코드만 바꾸면 다시 터진다.
중간에 터지면 임베딩 값이 날아간다. 5만 토큰쯤, 1원 조금 넘는 돈이다. 그걸 살리려고 반쪽 색인을 남기는 거래는 안 했다. 그 구조에서는 옛 청크가 이미 지워졌고 새 청크는 앞부분만 들어간 상태라, 화면은 실패라는데 검색에는 문서 앞부분만 걸린다. 쓰다 만 것을 걷어낸다. 뒤처리가 또 실패하면 로그만 남기고 삼킨다. 원인이 「저장 실패」에서 「청소 실패」로 바뀌면 안 된다.
하루 읽기 5만이 소진돼 멈췄다
아침에 배포하고 화면을 반복해서 열었다. 두 시간 만에 저장소 하루치 읽기 할당량이 다 나갔다. 그날 읽기 5만, 쓰기 319, 삭제 10. 순전히 읽기다.
「어떤 문서가 색인돼 있나」를 알아내려고 청크를 통째로 읽고 있었다. 현황 화면과 목록 화면이 각각 색인 셋을 훑고, 5분짜리 캐시는 배포할 때마다 0이 되고 색인을 쓸 때마다 버려진다. 앞에서 「캐시가 없으면 검색 열여섯 번에 하루치가 나간다」고 적어둔 그 일이 실제로 일어났다.
집계 쿼리를 쓰되 값으로 안 쓰고 캐시가 아직 맞는지 물어보는 용도로 썼다. 현황 자체는 집계로 못 바꾼다. 중복 제거도, 최신 시각도, 권한 교집합도 한 질의로 안 된다. 대신 캐시 수명이 지나도 바로 버리지 않고 개수만 물어본 뒤 그대로면 들고 있던 걸 그대로 쓴다. 집계는 읽기 과금에 안 들어간다. 캐시 수명은 5분에서 30분으로 늘렸다. 그게 지키는 건 「다른 인스턴스의 쓰기를 모른다」 하나뿐인데, 색인을 바꾸는 건 밤 자동화 한 번이다.
화면을 100번 열 때 읽기가 30,700건에서 613건이 됐다.
목록이 안 쓰는 벡터를 받아 오고 있었다
같은 화면이 열릴 때마다 10초씩 스켈레톤이 떴다. 문서 목록을 만들려고 청크를 통째로 받아 왔는데, 청크 하나 18KB 중 17KB가 벡터다. 목록도 통계도 그 벡터를 하나도 안 쓴다. 저장소 전체에 필드를 골라 받는 코드가 한 곳도 없었다. 필요한 일곱 필드만 받게 바꾸니 전송량이 11.3MB에서 0.17MB로, 역직렬화가 431ms에서 4ms로 줄었다.
여기서 하나는 정확히 말해야 한다. 읽기 건수는 1건도 안 줄었다. 필드 투영은 돌려줄 문서에 씌우는 마스크라 과금 단위를 안 바꾼다. 줄어든 건 회선과 역직렬화지 과금이 아니다. 과금을 줄인 건 앞의 집계 프로브 쪽이다.
그리고 10초가 다 설명되지는 않는다. 회선과 역직렬화로 3초에서 6초쯤 본다. 나머지는 콜드 스타트와 지연 초기화 쪽인데 안 쟀다. 배포하고도 느리면 다음에 볼 곳은 질의가 아니라 그쪽이라고 적어뒀다.
이 수정에는 뒤따라 잠금장치를 하나 세웠다. 무거운 캐시와 가벼운 캐시가 같은 타입이라, 무거운 자리에 가벼운 걸 넘겨도 타입 검사도 린터도 안 잡는다. 그 순간 벡터 없는 행이 검색에 들어가는데 화면은 멀쩡해 보인다. 순위를 융합하는 구조라 벡터 점수가 전부 0이어도 결과는 계속 나오고, 조용히 키워드 전용 검색이 된다. 어제 3등이던 게 오늘 없어져도 아무 데도 안 적힌다. 그래서 캐시를 인자에서 빼고 함수를 둘로 갈랐다. 잘못 부를 자리를 없앤 것이지 규약을 하나 더 만든 게 아니다.
라우터는 사용자 지침을 통째로 무시하고 있었다
지침에 「당신은 바리스타다, 말끝마다 나는 바리스타입니다를 붙여라」를 넣었는데 답이 「저는 새김스튜디오 사내 어시스턴트로서」로 나왔다. 서버 기본 지침의 첫 줄 그대로였다.
검색할지 말지를 정하는 라우터에 사용자 지침이 안 가고 있었다. 그런데 도구를 안 부르는 길에서는 라우터가 쓴 그 글이 그대로 답이 된다. 사용자 지침은 근거를 찾아 답하는 길에서만 쓰였고, 인사와 잡담과 일반 지식이 전부 그 반대쪽 길로 간다. 절반 이상이 서버 인격으로 나가고 있었던 셈이다.
기본 지침을 정체성·도구 규칙·문체 셋으로 갈라서 정체성만 갈아 끼운다. 서버 정체성을 남기고 사용자 것을 덧붙이는 방법도 있었지만, 그러면 정체성이 둘이 되고 그때 모델은 앞에 있고 시스템 말투인 서버 것을 고른다. 화면 첫 줄이 서버 지침 첫 줄이었던 게 그 증상이다. 시스템 프롬프트는 앞머리가 인격을 정하고 뒤따르는 것이 그 인격이 지킬 규칙으로 읽힌다.
검색어를 다시 쓰는 쪽에는 지침을 안 넣었다. 갈리는 지점은 출력이 어디로 가느냐다. 라우터 출력은 사람에게 가고 재작성 출력은 임베딩과 키워드 검색으로 들어간다. 바리스타 지침을 넣으면 검색어가 「한국커피문화연구 나는 바리스타입니다」가 된다. 얻는 것 없이 검색만 나빠진다.
어떤 추론으로 이 답이 나왔나
「어떤 과정을 거쳐 이 답이 나왔는지 알고 싶다」는 요청이 왔다. 모델 사고를 스트리밍하는 건 큰 일인데, 그 전에 파이프라인이 이미 계산해놓고 버리는 값이 둘 있었다. 검색을 걸었는지, 그리고 무슨 말로 검색했는지.
둘 다 응답에 싣는다. 사실 하나만 있어도 나머지가 정해지는데 굳이 가른 이유는, JSON에서 null은 「안 했다」와 「이 서버는 그걸 모른다」가 같은 모양이기 때문이다. 웍스와 엔진은 따로 배포되니 안 주는 서버가 있을 수 있고, 그때 false로 메우면 모든 답에 「찾아보지 않았다」가 뜬다. 점수를 0으로 메우는 것과 스탠스가 다른 이유는, 0은 그럴듯한 숫자지만 false는 단정이라서다.
검색어가 원문과 같아도 싣는다. 「원문 그대로 나갔다」는 없음이 아니라 판정이다. 보일지 말지는 화면이 정한다. 화면에는 답 아래 한 줄이고, 네 갈래 중 둘은 침묵이다. 평소엔 이 줄이 아예 없고 뜨는 것 자체가 신호다.
그리고 그 한 줄이 다음 날 하루를 설명했다.
라우터가 검색 범위를 못 보고 있었다
검색 대상을 「프로젝트」로 좁혀놓고 「9월에 뭘 했지?」를 물었다. 위키와 개발일지가 묶인 방이고 자료가 111건, 그중 개발일지가 62건이다. 답은 이랬다.
안녕하세요! 9월에 뭘 하셨는지는 저도 모르겠네요.
찾아보지 않고 답해서 출처가 없습니다.
라우터가 잡담으로 판정하고 색인을 아예 안 뒤진 것이다. 그날 「검색이 왜 안 되나」로 여러 번 돌았는데 그때마다 원인이 달랐다. 소급이 안 됐고, 할당량이 찼고, 색인이 실패했고, 이번엔 아예 안 찾았다. 앞의 셋을 고치는 동안 마지막 하나가 안 보여서 계속 다른 데를 팠다. 어제 넣은 한 줄이 아니었으면 그날도 못 찾았을 것이다.
원인이 둘이었다. 라우터에 검색 범위가 안 갔다. 지식베이스를 골라 좁힌 것 자체가 「여기서 찾아라」인데 못 본다. 그리고 기본 지침의 예시가 올린 문서, 파일 위치, 사람과 조직, 예산과 일정뿐이라 「내가 언제 무엇을 했나」가 없었다. 그게 개발일지의 정체인데.
「좁혔다」를 무엇으로 재느냐가 여기서 갈렸다. 색인 이름으로 재면 모든 호출이 좁힌 게 된다. 부르는 문 셋이 전부 빈 값을 「볼 수 있는 전부」로 채워서 사실상 늘 차 있기 때문이다. 지식베이스 목록은 아무도 자동으로 안 채운다. 비어 있지 않다는 건 사람이 실제로 골랐다는 뜻이다.
그래도 무조건 찾게 하지는 않았다. 라우터를 만든 이유가 「안녕?」에 문서를 안 뒤지는 거였고, 범위를 고른 사람도 인사는 한다. 고른 건 「무엇을 뒤질까」를 정한 거지 「이제 다 뒤져라」가 아니다. 알려주고 애매할 때 찾는 쪽으로 기울이는 데까지만 했다. 그 예외를 안내문 안에 같이 못 박았다. 안 적으면 이 블록이 무조건 찾기로 샌다.
정직하게 덧붙이면, 이게 실제로 고쳐졌는지는 코드로 못 보인다. 부를지 말지는 모델이 정한다. 코드로 보인 건 라우터 입력에 전에 없던 두 신호가 들어갔다는 것까지다.
수십 초 동안 화면은 아무것도 모른다
「무슨 말로 검색했나」를 응답에 실은 건 좋았는데, 그건 끝난 뒤에 온다. 한 번 부르고 수십 초 기다렸다가 답만 오는 동안 파이프라인이 무엇을 했는지 화면이 하나도 모른다. 색인도 같다. 수십 초가 걸리는데 「진행 중」 한 마디뿐이라 멈춘 것과 구별이 안 됐다.
이미 알던 값을 줄로 흘린다
모델 사고를 스트리밍하는 건 큰 일이다. 그 전에 파이프라인이 이미 계산하고 버리던 값부터 냈다. 찾아볼 일인지 정하는 중, 정했음, 모델이 적어둔 판단, 검색어를 다시 쓰는 중, 나간 검색어, 후보와 근거와 탈락 수, 답을 만드는 중, 인용 N개 중 M개 확인. 여덟 걸음 전부 새로 계산한 게 아니다.
마지막 하나가 추가 발견이었다. 모델이 적은 인용을 원문과 대조하는 건 원래 하고 있었는데, 「셋 적었고 하나는 원문에 없었다」가 화면 어디에도 없었다.
새 문을 내면서 신경 쓴 건 옛 문과 답이 갈릴 자리를 없애는 것이었다. 옛 엔드포인트를 남겨야 했다. MCP 도구와 앱 MCP가 그걸 쓴다. 그래서 답을 만드는 함수를 껍데기로 바꿨다. 스트리밍 생성기를 끝까지 돌려 결과 하나만 집고 걸음은 버린다. 응답 몸통도 한 함수가 짓는다. 갈라 적으면 나중에 필드가 하나 늘 때 한쪽에만 붙는다.
작은 것 하나를 더 정했다. 스트리밍 쪽을 통째로 생성기로 만들면 빈 질문 검사가 첫 호출까지 미뤄진다. 그러면 이미 200과 헤더를 내보낸 뒤에 400을 알게 되고, 그때는 상태 코드로 말할 방법이 없다. 검사는 즉시 하고 도는 일만 생성기에 뒀다.
SSE 배관은 새로 짰다. 1KB 패딩이 전부인 파일인데, 같은 여섯 줄이 이미 제품 쪽에 있다. 갖다 쓰지 않았다. 그 모듈은 불러오는 순간 저장소·임베딩·도구 정의·MCP 클라이언트를 통째로 끌고 와서, 공용 배관이 끝난 제품의 그래프에 의존하게 되고 테스트도 그 전부를 세워야 돈다. 의존 방향이 거꾸로 되는 것보다 여섯 줄을 두 벌 두는 편이 싸다고 봤다. 대가는 파일에 적어뒀다. 패딩 값을 고칠 일이 생기면 두 자리를 같이 고쳐야 한다.
토큰 단위 스트리밍은 안 했다. 답이 강제 도구의 인자로 오고, 그 강제가 날조 방어의 한 겹이다. 부분 JSON에서 답만 뽑으려면 파서를 하나 더 만들어야 하는데 답이 두세 문장이라 얻는 게 1초에서 2초다. 걸음 표시로 덮었다.
색인 쪽은 중지를 안 건다
답변은 받는 쪽이 사라지면 다음 모델 호출을 안 부른다. 화면을 닫았는데 요금이 계속 나가면 안 되니까. 색인은 일부러 반대로 했다.
끊어서 아낄 돈이 없다. 돈이 나가는 단계(캡션 모델)가 맨 앞이라 끊을 수 있게 될 즈음엔 이미 다 쓴 뒤다. 그리고 끊으면 자료가 사라진다. 옛 조각을 지우고 새 조각을 넣는 순서라 그 사이에서 접히면 색인에서 통째로 없어진다. 무엇보다 사용자는 「이 파일을 색인해라」라고 시켰다. 화면을 떠난 게 「그만두라」는 아니다. 답변은 화면이 곧 결과라 다르다.
진행률 막대는 안 만들었다. 걸음 시간이 극단으로 불균등해서 캡션 만드는 단계 혼자 20초에서 40초다. 「3/7 = 43%」가 30초 넘게 안 움직인다. 멈춰 보이는 화면을 고치려다 진짜 멈춘 막대를 세우는 일이다.
색인 서비스에는 선택 콜백 하나만 달았다. 안 주면 아무 일도 안 한다. 그래서 기존 색인 엔드포인트는 한 바이트도 안 바뀐다.
검색기만 바깥 것으로 갈아 끼울 자리
색인과 검색과 답변이 한 몸이라 검색만 남의 것으로 바꿔 끼울 자리가 없었다. 비교해보고 싶은 바깥 엔진은 검색 API만 열려 있고 답변 생성이 없다. 「바깥으로 찾고 여기서 답한다」가 되면 두 엔진을 같은 정답셋으로 나란히 잴 수 있다.
요청 필드 하나로 갈랐다. 기본값이 기존 엔진이라 안 보내면 코드 경로가 한 줄도 안 바뀐다. 앱 설정에 넣는 안은 접었다. 앱을 하나 발행해야 엔진을 고를 수 있게 되면 단계가 하나 더 생긴다.
어댑터가 바깥 응답을 기존 타입으로만 옮긴다. 그래서 답변 파이프라인은 엔진을 모른 채 그대로 돈다. 갈리는 자리는 검색 라우터, 답변 인자 조립, 근거 후보 뽑기 셋뿐이다.
점수에서 하나 배웠다. 바깥 엔진이 주는 벡터 유사도는 0.96에서 0.98 사이에 몰려 있어 아무것도 못 거른다. 정답과 잡음의 차이가 0.002다. 재순위 점수는 정답 0.99, 잡음 0.03으로 벌어진다. 근거 판정이 뜻을 가지려면 그쪽이라, 판정이 보는 자리에 재순위 점수를 넣고 원래 유사도는 「얼마나 몰려 있나」를 재라고 따로 실었다.
대신 방어 한쪽이 이 경로에는 없다. 바깥 엔진은 어느 갈래가 잡았는지를 안 알려준다. 그래서 키워드 점수가 늘 0이고, 근거 판정이 벡터 단독 문턱이 된다. 「글자 그대로 걸린 건 유사도가 낮아도 근거다」가 여기서는 안 산다. 없는 값을 지어내는 대신 주석에 적었다.
바깥 엔진의 주소와 키는 코드에 없다. 로컬 설정에만 둔다. 배포 환경변수에는 안 넣어서 배포에서는 언제나 꺼져 있다. 이건 프로덕션 기능이 아니라 재보기 위한 자리다. 서버를 띄운 통합 검증은 아직 안 했다.
고른 것을 모델에게 다시 묻지 않는다
바깥 엔진을 골라놓고 수수료를 물었는데 도구를 안 부르고 일반 상식으로 답했다. 화면에는 「찾아보지 않고 답해서 출처가 없습니다」가 떴고 바깥 엔진은 불리지도 않았다.
엔진 선택이 근거를 어디서 뽑나에만 걸려 있었다. 그 앞에 라우터가 있고, 라우터의 정체성은 이쪽 색인이라 바깥 지식에 대한 물음을 자기와 상관없는 잡담으로 판정한다.
고른 것이 곧 「거기서 찾아라」다. 사용자가 이미 정해준 것을 모델에게 다시 물을 이유가 없어서 이 갈래는 라우터를 아예 안 부른다. 앞에서 쓴 것처럼 지침으로 기울이는 방법도 있었는데 안 택했다. 기울이는 것이지 강제가 아니라 경계에서 같은 판정이 다시 나올 수 있다.
걸음 표시도 같이 고쳤다. 이 갈래의 첫 걸음은 「정했다」다. 정하는 일이 없는데 「찾아볼 일인지 정하고 있습니다」를 띄우면 안 하는 일을 하는 중이라고 말하는 것이 된다.
대조를 무르게 하는 대신 원문을 편다
바깥 엔진의 자료가 구조화된 기록이면 근거 대목이 이렇게 온다.
20260914_1320000-0001 : {"사무명": "경비업 허가신청", "수수료내역": "10,000원"}
모델은 그걸 읽고 사람이 읽을 말로 옮겨 적는다. 「수수료내역: 10,000원」이라고 쓰지 따옴표와 중괄호까지 옮기지 않는다. 글자 그대로 대조하니 그 둘이 다른 것이 되어, 답은 맞는데 「근거를 원문에서 확인하지 못했습니다」로 버려졌다. 앞에서 세운 방어가 청구서를 보낸 셈이다.
먼저 대조할 때만 구분 기호를 뗐다. 따옴표와 괄호와 쉼표와 콜론만 떼고 낱말과 숫자는 그대로 남긴다. 그래서 지어낸 인용은 여전히 떨어진다. 「10,000원」과 「10000원」이 같아지는 정도이고 그 둘이 다른 뜻이었던 적은 없다. 길이 판정은 떼기 전 값으로 한다. 떼고 재면 여덟 자짜리가 일곱 자로 줄어 최소 길이에 걸리는데, 짧은 인용을 막는 규칙이 구두점 유무로 갈리면 안 된다.
그런데 모자랐다. 낱말 순서와 조사가 달라지면 그래도 부분 문자열이 아니다. 여기서 대조를 더 무르게 하면 지어낸 답을 막는 장치가 무뎌진다. 그래서 반대로 갔다. 원문 쪽을 읽을 수 있게 만들고 대조는 빡빡한 채로 뒀다. 제목 줄을 살리고 키마다 한 줄로 편다. 그러면 모델이 한 줄을 그대로 옮겨 적을 수 있고, 덤으로 읽기도 쉬워진다. 객체로 안 읽히면 원문 그대로 돌려준다. 못 편 게 틀리게 편 것보다 낫다.
대조가 실패하면 모델이 적은 인용을 로그에 남긴다. 화면에 안 올리는 이유는 그 글이 지어낸 것일 수 있어서인데, 조사하는 쪽에는 그게 곧 단서다. 없으면 왜 안 맞았는지를 밖에서 알 방법이 없다. 실제로 그걸 못 봐서 한 번 헤맸다.
채점기에 실행부가 붙었다
여기까지가 검색 배관 이야기다. 그다음에 이 백엔드에 붙은 건 성격이 또 다르다. 법령해석 성능을 재는 일에 실행하고 채점하는 쪽으로 들어갔다. 작은 모델이 법령의 위임 사슬을 어디까지 타고 들어가는지를 재는 실험인데, 질의를 돌리는 루프와 답을 채점하는 심판이 필요했고 둘 다 여기 붙었다.
분명히 해둘 것이 있다. 새김AI가 법령 서비스를 하는 게 아니다. 끝난 제품의 백엔드가 다른 일의 부품으로 한 겹 더 쓰인 것이고, 프론트도 데스크톱 앱도 이번에도 커밋 한 줄 안 늘었다. 그리고 지금은 거기에도 없다. 2026년 10월에 이걸 통째로 걷어냈다. 왜 넣었다 뺐는지는 이 장 끝에 적었다.
채팅 경로를 일부러 안 탔다
가장 먼저 정한 게 이거다. 이미 도구를 부르고 답을 만드는 경로가 있는데 안 썼다.
그 경로는 사람이 채팅하는 자리라 스트리밍과 첨부와 대화 이력이 얽혀 있고, 모델이 claude일 때만 엔진이 갈리는 분기에 끌려다닌다. 앞에서 자랑처럼 쓴 그 3엔진 스왑이다. 그런데 비교하려는 축이 정확히 그 분기에서 무너진다. 모델을 바꿔 재려는데 모델에 따라 경로가 갈리면 무엇을 잰 건지 알 수 없다.
도구 쪽만 가져다 쓰고 루프는 따로 가졌다. 도구를 실행하는 함수도 안 썼는데 이유가 구체적이다. 그 함수는 도구 결과를 모델에게 「친근하게 한국어로」 다시 쓰게 한 뒤 그 글을 돌려주는 채팅용이다. 그걸 타면 평가 대상 모델이 법령 원문이 아니라 남이 쓴 요약을 읽게 되고, 층을 판정할 때 보는 첫 줄이 사라져서 사슬을 제대로 타고도 층 0으로 찍힌다. 덤으로 호출마다 요약 비용이 따로 나간다.
대가는 파일에 적어뒀다. 이 루프가 재는 건 새김AI 서비스가 아니라 이 루프다. 지금 목적에는 맞지만, 나중에 「우리 서비스가 얼마나 잘하나」를 재려 할 때 경로가 갈린 것이 함정이 된다. 앞서 saegim-eval에는 실제 검색 경로를 그대로 내줬는데 여기서는 반대로 갈랐다. 목적이 달라서다.
창을 먹는 게 셋이었다
작은 모델로 돌리니 컨텍스트가 계속 넘쳤다. 처음엔 도구 응답이 커서라고 봤다. 실제로 규정수량 고시의 별표 하나가 49,985자로 오는데, 그게 혼자 모델 컨텍스트의 66%다.
잘라 넣는 장치를 만들었더니 그래도 넘쳤다. 세 보니 도구 응답이 창의 48%밖에 안 되는데 넘친 판이 있었다. 나머지 절반은 시스템 프롬프트와 도구 정의와 대화 이력이었다. 도구 정의 열 개가 **10,943자, 창의 15%**다. 쓰지도 않을 도구 설명을 매 요청에 실어 보내고 있었던 것이다.
여섯 판을 돌려 보니 셋을 다 겹쳐야만 작은 모델이 사슬을 끝까지 탔다. 사슬 순서를 알려주는 프롬프트, 도구 응답 자르기, 도구 걸러내기. 하나라도 빠지면 넘치거나 멈춘다. 여기서 얻은 게 하나 있다. 규칙을 넣어 행동을 고칠 때마다 창이 줄어든다. 프롬프트를 길게 써서 잘 굴러가게 만들면 그만큼 담을 자리를 뺏는다.
자르기에는 부작용도 있었다. 잘린 응답에 찾던 행이 없으면 모델이 같은 별표를 네 번 열었다. 중복 금지 규칙을 넣어 두 번으로 줄였는데 아직 한 번은 아니다.
넘치는 건 실패가 아니라 재려던 현상이다
넘치면 루프가 예외로 죽어서 기록이 안 남았다. 그런데 넘쳤다는 사실 자체가 재려던 것이다.
컨텍스트 초과를 다른 실패와 갈라 적고, 죽이는 대신 그때까지의 기록을 돌려준다. 사슬을 놓쳐서 못 간 것과 자리가 없어서 못 간 것은 처방이 다르다. 앞엣것은 프롬프트를 고치고 뒤엣것은 응답 크기를 줄인다. 예외로 죽으면 둘을 구분할 자리 자체가 없다.
같은 이유로 잘못된 실행도 버리지 않는다. 왕복이 모자라 끝났든 컨텍스트가 넘쳤든 어디까지 열었는지는 계산으로 나오는 사실이고 그게 이 실험의 주 지표다. 무효라고 버리면 그 판에서 아무것도 못 배운다. 채점 쪽만 건너뛴다.
기록에서 하나를 갈랐다. 도구가 준 길이와 모델이 실제로 본 길이다. 자르기를 켜면 둘이 달라지는데, 원본으로 소비량을 재면 자르고도 넘친 것처럼 보인다. 실제로 원본 기준 93%로 찍힌 실행의 실제 소비가 41%였다. 반대로 층 판정은 자르기 전 본문으로 한다. 자른 뒤로 재면 판정이 어긋난다.
지표도 하나 더 세웠다. 사슬을 거슬러 올라간 횟수다. 얼마나 깊이 들어갔는지만 보면 순서대로 탄 실행과 아무 데나 찌른 실행이 같아 보인다. 실제로 시행규칙을 먼저 열고 상위법을 한참 뒤에 연 판이 둘 있었는데, 깊이로는 제대로 탄 판과 구별되지 않았다.
심판이 근거를 지어냈다
가장 오래 붙든 건 채점하는 쪽이었다.
모델이 쓴 답을 다른 모델이 채점하게 했는데, 심판이 답변에 없는 내용을 세 번 다 「일치」로 판정했다. 답변에 그런 말이 없는데 있다고 한 것이다. 채점기가 틀리면 그 위의 모든 숫자가 의미를 잃는다.
「지어내지 마라」를 프롬프트에 더 적는 길로 가지 않았다. 대신 일치라고 하려면 답변에서 그대로 따온 문장을 같이 내게 하고, 그 문장이 답변에 실제로 있는지 코드가 글자로 대조한다. 없으면 불일치로 내린다. 앞에서 모델이 적은 출처를 인용구로 검증하던 그 수법을 이번엔 심판 자신에게 걸었다.
문턱은 실측으로 정했다. 겹침 비율을 재 보니 그대로 따온 문장은 1.00, 말을 바꿔 적은 인용은 0.74에서 0.88, 지어낸 인용은 0.13에서 0.31이었다. 두 무리가 확실히 갈라져서 그 사이인 0.6을 잡았다. 강조 표시나 따옴표 종류처럼 심판이 흔히 바꿔 적는 꾸밈은 떼고 대조한다. 그것까지 거짓으로 몰면 맞는 인용이 같이 떨어진다.
채점 기준도 하나 버렸다. 결론에 라벨을 붙여 맞히게 했는데, 공무원 회신은 「의무발생」이고 AI 답변은 「조건부」로 갈렸다. 그런데 가리키는 결론은 똑같이 4년이었다. 말투가 다르다는 이유로 맞는 답이 깎이고 있었다. 라벨 맞히기를 버리고 실질 결론이 같은 것을 가리키는지만 보게 바꿨다. 라벨은 사람이 읽을 표기로만 남겼다.
요점 대조도 맞다와 틀리다 둘에서 셋으로 늘렸다. 방향은 맞는데 근거를 덜 짚었거나 수치를 확인 못 했다고 스스로 밝힌 답을 한쪽으로 몰면 둘 중 어느 쪽으로 몰아도 틀린다.
그러고 나서 심판 자격을 따로 쟀다. 한 모델은 손으로 매긴 채점과 열다섯 칸이 전부 일치해서 심판으로 썼고, 처음에 근거를 지어낸 모델은 요점 대조에서 어긋나 심판으로 쓰기엔 부족하다고 적어뒀다. 사내 모델도 심판으로 열었는데, 그 갈래에는 심판이 물러터졌는지를 자동으로 재는 자리가 없다는 것을 코드 주석에 같이 박았다. 막을 장치가 없으면 최소한 다음 사람이 알고는 쓰게.
열네 판을 터미널에서 돌리고 나서야 문을 냈다
여기까지 전부 터미널에서 돌렸다. 화면에서 부를 문이 없었다.
셋을 냈다. 드롭다운 값을 주는 문, 실행을 시작하는 문, 상태를 보는 문. 실행이 1분에서 2분이라 작업 번호를 먼저 주고 화면이 물어보게 했다. 앞에서 답변과 색인에는 스트리밍을 깔아놓고 여기는 안 깔았는데, 가른 기준은 연결을 얼마나 오래 붙잡나다. 도구를 스물몇 번 부르는 동안 연결을 쥐고 있으면 게이트웨이와 재배포에 그만큼 약하다. 물어보는 방식은 끊겨도 이어 볼 수 있다.
주소와 키는 안 내려보낸다. 백엔드 미러가 공개라 API 응답은 브라우저 네트워크 탭에 그대로 뜬다. 모델은 이름과 표시명만 나간다. 같은 이유로 예외 원문도 결과에 안 싣는다. HTTP 클라이언트 예외 문자열에는 호출한 주소가 붙는 경우가 있어서, 주소를 코드에 안 박아둔 노력이 거기서 무효가 된다.
네 문 전부에 인증을 붙였다. 실행 한 번이 도구를 수십 번 부르고 심판까지 붙어 돈이 들고, 결과에는 채점 사유로 민원 원문의 요지가 인용된다. 아무나 읽으면 안 된다. 평가 자료와 결과가 쌓이는 폴더도 추적 제외에 넣었다. 첫 실행이 만드는 폴더에 민원 원문이 들어가는데 공개 미러로 나갈 뻔했다.
화면 기본값도 고쳤다. 모델 목록 첫 항목이 화면 기본값인데 가장 비싼 모델이 맨 앞이었다. 중지하는 문이 아직 없어서 폼을 열고 바로 누르면 못 멈추고 5달러가 나간다. 작은 모델을 앞에 세웠다. 이 실험의 주인공이 작은 모델이기도 하다.
배포가 두 번 막혔다
같은 파일이 두 관문에서 각각 걸렸다.
채점기를 백엔드 안에 복사해두고 커밋까지 했는데도 배포가 안 됐다. 배포 스크립트가 app/ 폴더만 옮기고 있었다. 그런데 그 폴더 안의 코드가 기동할 때 채점기를 불러온다. 그대로 올리면 서버가 통째로 안 뜬다. 앞서 「커밋해야 미러에 실린다」를 배웠는데, 커밋해도 옮기는 목록에 없으면 안 간다는 게 따로 있었다.
두 번째는 정답지였다. 운영 컨테이너에서 케이스 목록이 비어 있었다. 정답지 폴더가 추적 제외인데(민원 원문이 든다) 배포 스크립트도 그 폴더를 안 옮기니 파일로는 영영 안 실린다. 파일이 있으면 파일, 없으면 저장소에서 읽게 했다. 파일을 우선하는 건 로컬에서 고쳐 바로 돌려 보는 길을 막지 않으려는 것이다.
둘을 섞지는 않았다. 파일이 한 건이라도 있으면 목록은 파일 것만이다. 섞으면 「어느 쪽에서 온 정답지인가」가 케이스마다 달라지고, 로컬에서 고친 게 저장소 것에 덮여 보이는지를 매번 확인해야 한다.
여기서 배포 스크립트의 오래된 버그도 하나 걸렸다. 작업 폴더가 살아 있는지를 .git 폴더가 있는지로 봤는데, 맥이 임시 폴더를 청소하면 껍데기만 남아 검사를 통과하고 그다음 단계에서 죽는다. git이 실제로 읽는지를 묻게 바꿨다.
그리고 전부 걷어냈다
문을 내고 법령 조회 서버까지 같은 컨테이너에 띄운 게 9월 중순이다. 10월 6일에 다 지웠다. 라우터, 실행 루프, 저장, 큐, 정답지, 채점기 복사본, 시작 스크립트. 44개 파일에서 6,627줄이 빠졌다.
커밋에 이유를 한 줄로 적었다. 부르는 곳이 없었다. 평가는 별도 엔진으로 옮겨 가 있었고, 여기 남은 건 더 안 쓰는 배관이었다.
지우면서 세 군데는 일부러 남겼다. 하나는 데이터베이스 보안 규칙이다. 정답지 문서에 민원 원문이 들어 있는데, 코드를 지워도 문서는 그대로 남는다. 규칙까지 같이 지우면 지키던 게 풀린다. 그래서 읽는 코드가 없어진 컬렉션을 계속 닫아두고, 파일에 왜 닫아두는지를 적었다. 둘째는 채팅에서 서버를 가리는 구조다. 가릴 대상이 없어져 비었는데 틀만 남겼다. 평가용 서버를 붙이면서 채팅이 그 도구를 전부 집어 가던 걸 막으려고 만든 자리라, 같은 일이 또 생기면 거기 이름만 넣으면 된다. 셋째는 미러 저장소에 남은 두 파일이다. 스크립트가 자동으로 안 지우게 하고, 지우기 전에 배포 대시보드의 시작 명령을 먼저 보라고 주석을 달았다. 거기 그 파일이 박혀 있으면 지우는 순간 서버가 안 뜬다.
반대로 평가와 상관없이 서는 것은 그대로 뒀다. 사내 추론 서버의 끊긴 인증서 체인을 이미지에서 메우는 블록이 그렇다. 그 서버가 중간 인증서를 안 보내서 curl은 되는데 파이썬만 전부 연결 실패가 났던 자리다. 평가 때문에 발견했지만 평가 코드는 아니다.
이 장을 쓰면서 가장 정직한 대목이 이거다. 끝난 제품의 백엔드가 남의 일감을 한 겹 받아 쓸 수 있었던 건 쓸모가 남았다는 뜻이고, 그 일감이 제 집을 찾았을 때 미련 없이 떼어낸 것도 같은 판단의 다른 쪽이다. 이 프로젝트가 실패한 이유가 「모든 걸 넣어서」였으니까.
- 백엔드: Python 3.11 · FastAPI 0.115 · APScheduler(실질 스케줄러) · Meilisearch · numpy
- AI: anthropic 0.113 · openai 1.58 · langgraph 1.2 · langchain-core · mcp 1.12
- 모델:
claude-sonnet-4-6/gpt-4o· 경량claude-haiku-4-5· 이미지gpt-image-1 - 데이터: Firebase Firestore(25 컬렉션) · Storage · Meilisearch(키워드)
- 프론트: React 19 · Tauri 2 · Capacitor(iOS) · zustand · TypeScript
- 배포: Railway (uvicorn 단일 프로세스)
Celery+Redis는 스택에서 뺐다. 원래 알림 시스템을 Redis 브로커 + Celery Beat로 돌렸지만 APScheduler in-process로 이관했다. "죽은 코드"가 아니라 "쓰다가 걷어낸 코드"다.
왜 이 스택
기술은 "좋아서"가 아니라 "이 규모·맥락에 맞아서" 골랐다. 방어되는 이유만 적는다.
- FastAPI: 토큰 스트리밍(SSE)과 async가 native로 되고, AI SDK(anthropic·openai)가 전부 Python이라 백엔드도 Python으로 붙였다. Django보다 가볍고 async에 강하다.
- Firestore: 1인 프로젝트라 저장소 운영을 지고 싶지 않았다(관리형·서버리스). 인증을 이미 Firebase로 해서 per-user 보안 규칙으로 "내 데이터만 내가" 격리가 공짜였고, 형태가 제각각인 개인 데이터엔 문서형 스키마가 유연하다. 단 벡터 검색이 없어 브루트포스 코사인으로 우회했다. 개인 규모(몇 만 건)엔 순식간이지만 프로덕션 규모면 이 선택이 뒤집힌다(그땐 OpenSearch, 실제로 RagOps에서 그렇게 했다).
- Meilisearch: 벡터 검색과 별개로 정확한 키워드 검색이 필요했다. Elasticsearch는 개인 규모에 무겁고, Meilisearch는 가볍고 셋업이 빠르다.
- Tauri: 같은 웹 프론트를 데스크톱으로 재사용하되 Electron의 번들·메모리 부담을 피하려 Rust 기반 Tauri를 택했다. 하나의 프론트를 웹·데스크톱·iOS(Capacitor) 셋으로 재활용한다.
Trouble Shooting
- LangGraph
<thinking>누수. 사고 과정이 답변에 새거나 화면이 비었다.<thinking>블록을 분리 처리해 해결했다. - 추론 엔진에서 출처 뱃지 소실. 뱃지는 "LLM 단일턴 마커 생성" 파싱 구조인데 다단계 추론이 마커 보존을 깼다(버그가 아닌 구조 충돌). 라운드 스코프 분리(1툴 verbatim / 체이닝 종합)로 해결했다.
- GraphRAG 항상 빈 화면 → 진짜 원인은 상류. 화면 코드를 의심했지만, 로그를 보니 기억 추출기가 모델 응답을 그대로 파싱하는데 모델이
```json코드펜스로 감싸 모든 기억 추출이 실패하고 있었다(기억 0 → 그래프 항상 빔). 펜스를 제거해 막았다. 교훈은 이렇다. "화면이 비었다"의 원인이 화면 코드란 보장은 없다, 로그가 가리키는 상류를 봐라. - 새로 만든 검색이 403으로 죽었는데 원인이 코드가 아니었다. 본체 Firebase 프로젝트가 요금 문제로 삭제돼 있었고, 색인을 거기 두는 구조라 통째로 못 쓰게 된 것이다. 초기화 코드가 설정이 없어도 경고만 찍고 개발 모드로 넘어가는 바람에, 프로젝트가 사라진 사실을 남의 말로 된 403을 받고서야 알았다. 색인은 전용 프로젝트로 분리하고, 설정이 없으면 무엇이 없는지 이름을 대고 죽게 바꿨다.
- Claude 529 과부하가 엔진마다 다르게 새어 나왔다. 직접 구현한 native 경로는 3회 지수 백오프(1·2·4초)와 안내 문구를 갖췄는데, LangGraph 경로는 SDK 기본 재시도만 걸려 있어 과부하 응답을 그대로 사용자에게 덤프했다. SDK 재시도를 4회로 늘리고 529(서버 혼잡)와 429(요청 몰림)를 갈라 문구를 붙인 뒤, native 쪽 문구도 같은 케이스로 맞췄다. 엔진을 셋으로 늘리면 에러 처리도 세 벌이 된다는 유지비용을 여기서 치렀다.
- 트랜잭션 초과의 원인이 문서 크기가 아니었다. PDF 색인이 「트랜잭션이 너무 큽니다」로 죽었는데 페이로드는 상한의 26%였다. 배열 필드가 원소 수만큼 색인 항목을 만들어서, 1536차원 벡터 하나가 청크당 1,500개가 넘는 항목이 됐다. 한도를 문서 크기로만 생각하면 영영 못 찾는 종류다. 배치를 개수가 아니라 색인 항목을 포함한 무게로 끊어 해결했다.
- 답은 맞는데 근거 검증에서 버려졌다. 색인에 든 자료가 구조화된 기록이면 근거 대목이 중괄호와 따옴표로 온다. 모델은 그걸 사람이 읽을 말로 옮겨 적으니 글자 대조가 안 맞고, 지어낸 걸로 판정돼 답 자체가 안 나갔다. 대조를 무르게 하면 진짜 방어가 같이 무뎌지므로 반대로 갔다. 구분 기호만 떼고 대조하되 원문 쪽을 키마다 한 줄로 펴서, 모델이 한 줄을 그대로 옮겨 적을 수 있게 했다.
- 응답이 본문 없는 500으로 나갔다. 저장소 예외를 감싸지 않은 서비스가 셋 있었고, 그중 키 검증은 의존성에서 도는 자리라 어떤 라우터의 try로도 못 잡는다. 앱 한 곳에 저장소 예외 처리기를 세워 「색인 저장소의 하루 읽기 한도가 찼습니다」로 바꿨다. 할당량 초과는 502가 아니라 503으로 냈다. 502는 저쪽이 고장났다는 뜻인데 이건 잠시 뒤 풀린다.
Decision Log
프레임워크가 감추는 추론 루프를 직접 이해하려고. 함수콜링·스트리밍·RAG를 직접 만들면 원리가 남고, 새 프레임워크 내부가 먼저 보인다는 가설.
학습 목적으로 native로도, LangGraph로도 만들어 차이를 몸으로 겪었다. 결론은 native였다. 기능이 더 넓고(gpt·첨부 커버), 프롬프트 캐싱으로 더 싸고, 프레임워크가 주는 상태관리는 이미 Firestore가 하고 있어 더 얹을 게 없었다. "프레임워크는 마법이 아니라 도구."
전부 다단계 종합으로 통일하지 않았다. 1툴 라운드는 원문 그대로 인용 마커를 보존하고, 2라운드 이상만 종합한다. 기능별 요구가 다르면 경로를 가른다.
원래 카톡 알림을 Redis 브로커 + Celery Beat(60초 발행) + 워커로 돌렸다. 별도 워커·브로커가 떠 있어야만 알림이 나가는 의존성이 배포 환경에 과했다. 커밋 하나로 APScheduler in-process로 완전히 이관했다. API 프로세스 하나가 폴링·발송하도록 단순해졌다. 돌려보고 안 맞아서 걷어낸 판단이다.
18앱 모놀리식은 진입장벽이 높다. "캘린더 하나 써봐"가 허들이 낮고, 캘린더는 데이터 생성 빈도가 높아 AI 시연 효과가 즉각적이다.
AI 사이드바를 붙였다가 하루 만에 4,650줄을 들어냈다. 전략을 "앱=데이터 저장 / 런처=AI 인터페이스"로 정리했다. 앱마다 AI를 박는 대신 AI는 한 곳(런처)에 뒀다.
끝난 제품의 백엔드를 다른 제품이 갖다 쓰게 되면서 그은 경계. 임베딩 모델이나 청크 크기를 바꾸면 색인을 전량 다시 만들어야 하는데, 제품마다 색인을 들고 있으면 그때 제품을 하나씩 찾아다녀야 한다. 원본은 제품에 남기니 파이프라인을 갈아끼워도 잠기지 않는다.
코사인 절대값은 질의와 청크 길이에 좌우돼서 어떤 숫자를 박아도 정답을 자르고 오답을 통과시킨다. 실제로 0.276짜리 정답이 잘리고 0.361짜리 오답이 통과했다. 임계값 대신 벡터와 키워드의 순위를 융합하고, 판정은 점수가 아니라 근거를 보고 한다.
접두사로 가르면 판정이 문자열 모양에 의존하고, 모양이 겹치는 값이 오면 조용히 엉뚱한 검증기로 간다. 헤더가 다르면 그 판정 자체가 없다. 덤으로 기존 사람 인증 경로를 한 줄도 안 고친다. 키를 발급하는 창구만 사람 전용으로 뒀다. 권한을 나눠 주는 일은 나눠 받은 쪽이 못 한다.
부르는 쪽이 자기 범위를 스스로 선언하면 그건 칸막이가 아니다. 그리고 같은 목록이 읽기에서는 "이만큼까지 보겠다", 쓰기에서는 "이만큼에게 보여주겠다"라 비었을 때 안전한 답이 뒤집힌다. 읽기는 가진 것 전부, 쓰기는 안 밝히면 거절.
세션을 들면 처음 한 번의 자격이 그 뒤 전부에 쓰여서 키를 폐기해도 살아 있는 세션은 안 죽는다. 그리고 로그인 토큰은 한 시간이면 만료돼 설정 파일에 적어 둘 수 있는 값이 아니다. 받아 주면 되는 것처럼 보이다가 한 시간 뒤 죽는 설정이 생긴다.
개발일지를 넣어 보니 검색 스니펫이 커밋 해시 나열이었다. 그날 무엇을 했나의 기록은 읽을 문장이 아니라 목록이다. 위키로 갈았다. 왜 그렇게 정했는지가 문장으로 있어야 "이거 왜 이렇게 했더라"에 답이 된다. 남이 쓴 기사는 뺐다. 섞이면 자기 것을 찾을 때 남의 것이 같이 올라온다.
앱마다 낸 MCP 도구는 검색어만 받는다. 범위 인자를 열어 두면 모델이 넓혀 부르고, 원두만 보라고 만든 바리스타가 아무거나 답하기 시작한다. 같은 이유로 MCP 인스턴스도 앱마다 만들지 않는다. 세션 관리자는 서버가 뜰 때 열리는데 앱은 런타임에 생겨서, 앱마다 인스턴스를 만들면 뒤에 생긴 앱은 첫 호출에서 죽는다.
소급을 목록 조회의 뒷일로 얹었다가 열흘 만에 걷어냈다. 도장 쓰기가 할당량 초과로 실패하면 다음 요청이 또 300건을 읽는 되먹임이 된다. 할당량이 모자라서 실패한 일이 할당량을 더 먹는다. 아무도 안 부르는 문이 쓸모없는 건 맞지만, 평소 경로에 일을 얹으면 그 일이 실패할 때도 평소 경로에서 실패한다.
대용량 색인이 중간에 터지면 옛 청크는 이미 지워졌고 새 청크는 앞부분만 들어간다. 화면은 실패라는데 검색에는 문서 앞부분만 걸린다. 날아가는 임베딩 비용이 1원 남짓이지만 그걸 살리려고 반쪽 색인을 남기는 거래는 안 했다. 대가는 재색인이 실패했을 때 「색인 전」이 아니라 「색인 없음」이 되는 것이다. 섞인 것보다 없는 게 낫다고 봤다.
사용자 지침을 서버 지침 뒤에 덧붙이는 대신 정체성 부분만 갈아 끼웠다. 덧붙이면 정체성이 둘이 되고, 그때 모델은 앞에 있고 시스템 말투인 서버 것을 고른다. 대신 검색어를 다시 쓰는 쪽에는 지침을 안 넣는다. 갈리는 지점은 출력이 어디로 가느냐다. 라우터 출력은 사람에게 가고 재작성 출력은 임베딩과 키워드 검색으로 들어간다.
옛 엔드포인트를 남겨야 했다. MCP 도구가 그걸 쓴다. 그래서 답을 만드는 함수를 스트리밍 생성기의 껍데기로 바꿨다. 생성기를 끝까지 돌려 결과 하나만 집고 걸음은 버린다. 응답 몸통도 한 함수가 짓는다. 두 문의 답이 갈릴 자리를 구조적으로 없애는 방법이 이것 하나다. 갈라 적으면 나중에 필드가 하나 늘 때 한쪽에만 붙는다.
답변은 받는 쪽이 사라지면 다음 모델 호출을 안 부른다. 색인은 일부러 반대다. 돈이 나가는 단계가 맨 앞이라 끊어서 아낄 게 없고, 옛 조각을 지우고 새 조각을 넣는 순서라 중간에 접히면 그 자료가 색인에서 통째로 사라진다. 그리고 사용자는 「이 파일을 색인해라」라고 시켰다. 화면을 떠난 게 「그만두라」는 아니다.
구조화된 기록이 근거일 때 모델은 사람이 읽을 말로 옮겨 적어서 인용구 대조에 떨어졌다. 답은 맞는데 버려진 것이다. 여기서 대조를 더 무르게 하면 지어낸 답을 막는 장치가 같이 무뎌진다. 그래서 원문을 키마다 한 줄로 펴서 모델이 한 줄을 그대로 옮겨 적을 수 있게 하고, 대조는 빡빡한 채로 뒀다. 객체로 안 읽히면 원문 그대로 둔다. 못 편 게 틀리게 편 것보다 낫다.
이미 도구를 부르고 답을 만드는 경로가 있었지만 안 썼다. 그 경로는 사람이 채팅하는 자리라 스트리밍과 첨부와 대화 이력이 얽혀 있고, 모델이 claude일 때만 엔진이 갈리는 분기가 있다. 모델을 바꿔 재려는데 모델에 따라 경로가 갈리면 무엇을 잰 건지 알 수 없다. 도구 실행 함수도 안 썼다. 그건 결과를 모델에게 다시 쓰게 하는 채팅용이라, 평가 대상이 원문이 아니라 남의 요약을 읽게 된다. 대가는 적어뒀다. 이 루프가 재는 건 서비스가 아니라 이 루프다.
넘치면 루프가 예외로 죽어 기록이 안 남았다. 그런데 넘쳤다는 것 자체가 재려던 것이다. 다른 실패와 갈라 적고 그때까지의 기록을 돌려준다. 사슬을 놓쳐서 못 간 것과 자리가 없어서 못 간 것은 처방이 다르다. 앞엣것은 프롬프트, 뒤엣것은 응답 크기다. 같은 이유로 무효인 실행도 버리지 않는다. 어디까지 열었는지는 계산으로 나오는 사실이고 그게 주 지표다.
채점 모델이 답변에 없는 내용을 세 번 다 「일치」로 판정했다. 「지어내지 마라」를 더 적는 대신, 일치라고 하려면 답변에서 그대로 따온 문장을 같이 내게 하고 그 문장이 실제로 있는지 코드가 글자로 대조한다. 문턱은 실측으로 정했다. 그대로 따온 문장 1.00, 말 바꾼 인용 0.74에서 0.88, 지어낸 인용 0.13에서 0.31이라 그 사이를 잡았다. 앞에서 모델의 출처를 인용구로 검증하던 수법을 심판 자신에게 건 것이다.
도구 응답을 얼마나 자를지도, 어떤 도구를 줬는지도 결과가 아니라 조건이다. 기록에 안 남으면 두 판을 나중에 비교할 수 없고, 비교하는 두 모델에 같은 값을 써야 한다. 길이는 도구가 준 것과 모델이 실제로 본 것을 갈라 적는다. 원본으로 소비량을 재면 자르고도 넘친 것처럼 보인다. 실제로 93%로 찍힌 실행의 실제 소비가 41%였다. 반대로 층 판정은 자르기 전 본문으로 한다.
무엇이 과했나, 개인 AI OS의 함정
핵심 실패 명제는 README에 내가 직접 박아둔 그대로다: "모든 걸 넣어서 아무것도 아니게 됨."
- 24개 앱을 한 OS UI에 뭉쳐 진입장벽을 스스로 높였다.
- 프론트 코드의 약 42%가 진입로 없는 죽은 게임 코드였다. RE:CODE라는 38,910줄짜리 자체 2D 게임엔진이 여기 포함됐다. 그 콘셉트가 "AI에 대체된 개발자의 이세계 로그라이크"였는데, 공교롭게 이 프로젝트 자체의 은유가 됐다.
- 번들 하나라 메모 하나 고쳐도 전체 재배포. 웹 배포라 정작 사용자는 안 썼다.
집중을 시도했다(캘린더만 분리, AI 제거). 하지만 근본 과욕은 이미 굳어 있었고 결국 2026-04-09에 종료했다.
회고: 실패한 제품, 성공한 학교
한마디로 "실패한 제품이지만, 성공한 학교."
제품으로는 자기 진단 그대로다. 24개 앱, 프론트 42%가 진입로 없는 죽은 코드. "모든 걸 넣어서 아무것도 아니게 됨"은 변명이 아니라 정확한 부검 소견이다. 그런데 코드를 전수조사하고 나서 든 생각은, 이 프로젝트가 아까운 게 아니라 이 프로젝트를 통과한 사람이 남았다는 것이다.
프레임워크 없이 함수콜링·스트리밍·RAG를 직접 짜고, 그걸 LangGraph로 다시 짜서 나란히 비교하고, 그러고도 "프레임워크는 마법이 아니라 도구"라는 결론에 도달했다. 튜토리얼 따라 한 사람은 못 하는 궤적이다. Celery+Redis를 실제로 굴려보고 배포 환경에 안 맞으니 APScheduler로 걷어낸 판단, 청커 없이 가도 되는 규모를 알아본 감각. 다 "돌려보고 몸으로 안 것"들이다.
가장 값진 건 회고 자체다. 대부분은 실패를 미화하거나 지운다. 나는 README에 "모든 걸 넣어서 아무것도 아니게 됨"이라고 박아뒀고, 그 교훈을 다음 프로젝트 noon으로 실제로 이월했다. 확장이 아니라 집중으로. 틀린 걸 틀렸다고 쓸 수 있는 사람이 만든 포트폴리오는 화려한 것보다 믿음이 간다.
그래서 새김AI는 자랑이 아니라 "나는 이렇게 크게 실패했고, 정확히 무엇을 배웠고, 그래서 다음엔 이렇게 한다"의 증거로 여기 있다. 제품은 끝났지만 그 안에서 만든 검색 배관은 아직 굴러가고, 다음 도구들이 그 위에 올라탄다. 검색을 내주더니 이번엔 실행하고 채점하는 쪽까지 붙었다. 남은 게 제품이 아니라 부품이라는 게 이 프로젝트의 결론이고, 부품은 계속 다른 데 쓰인다.