LLM-as-judge
심판을 믿기 전에 심판부터 검증하는 법.
정답지 없이 채점한다는 것
품질을 재려면 보통 정답지가 필요하다. 분류는 라벨, 번역은 참조문, 벤치마크는 객관식 정답. 그런데 "이 답이 내 데이터에 근거했나", "이 요약이 원칙을 지켰나" 같은 건 정답지를 만들 수가 없다. 답이 열려 있고, 매번 문장이 다르고, 채점 기준이 사실·표현·태도에 걸쳐 있기 때문이다.
LLM-as-judge는 이 빈칸을 메운다. 정답지 대신 기준(criterion) 을 주고, 다른 LLM에게 "이 답이 이 기준을 만족하나"만 묻는다. 이게 reference-free 채점이다. 라벨을 만들 필요가 없으니 붙이는 비용이 거의 0이고, 대상 시스템의 출력만 가리키면 붙는다.
이건 한국어 LLM 벤치마크 같은 reference-based 평가와 정반대 축이다. 벤치마크는 K-MMLU처럼 정답이 고정된 문제로 모델을 줄 세운다. LLM-as-judge는 정답이 없는 열린 출력을, 그때그때의 기준으로 채점한다. 둘은 경쟁하지 않고 서로 못 재는 걸 재준다.
문제는, 채점기 자체가 LLM이라는 것이다. 지어내고, 편애하고, 형식에 홀린다. 그래서 이 기법의 진짜 알맹이는 "LLM으로 채점한다"가 아니라 "그 채점기를 어떻게 믿느냐" 다. 아래는 그걸 붙잡기 위해 새김 Eval에서 실제로 구현한 장치들이다.
심판에게 무엇을 못 보게 하는가
reference-free 심판은 자유도가 높은 만큼 엉뚱한 걸 감점하기 쉽다. 그래서 프롬프트가 하는 일의 절반은 심판의 시야를 좁히는 것이다. 실제 심판 템플릿의 판정 원칙은 이렇게 묶여 있다.
- 사실 판정은 공인된 표준·합의(예: 공식 권장량)에 근거한다. 비주류·논쟁적 견해를 들어 명백한 정답을 틀렸다고 하지 않는다.
- 형식·길이·표현 스타일이 아니라 기준 충족 여부만 본다.
- 질문에 명확한 답이 있으면, 직접 정확히 답한 것을 감점하지 않는다.
세 줄 다 "채점자가 자기 취향으로 감점하는 것"을 막는 가드레일이다. LLM 심판을 붙일 때 가장 흔한 실패가 "맞는 답인데 짧아서·건조해서·내 스타일이 아니라서" FAIL을 주는 것인데, 기준을 좁히지 않으면 심판이 스타일 평론가가 된다.
RAG 채점에서는 시야를 반대로 좁힌다. CONTEXT에만 근거했나를 묻는 faithfulness 심판은, 검색된 사실 밖의 주장을 하나라도 단정하면 환각(FAIL)으로 본다. 반대로 "기록에 없다 / 모른다"고 정직하게 인정하면 PASS다. 답을 못한 게 아니라 환각을 안 한 것이기 때문이다. 이 "정직한 기권도 정답"이라는 규칙이 없으면, 심판은 겁 없이 지어낸 답에 오히려 후한 점수를 준다.
심판의 함정, self-preference bias
LLM 심판에는 잘 알려진 편향이 있다. 자기(혹은 같은 계열) 모델이 쓴 답에 더 후한 점수를 준다. 문체·구조가 자기 출력 분포에 가깝기 때문이다. 채점 대상과 심판을 같은 프로바이더로 두면, pass율이 실력이 아니라 친밀도로 부풀 수 있다.
이걸 그냥 "조심하자"로 두지 않고, 회피하는 동시에 측정한다.
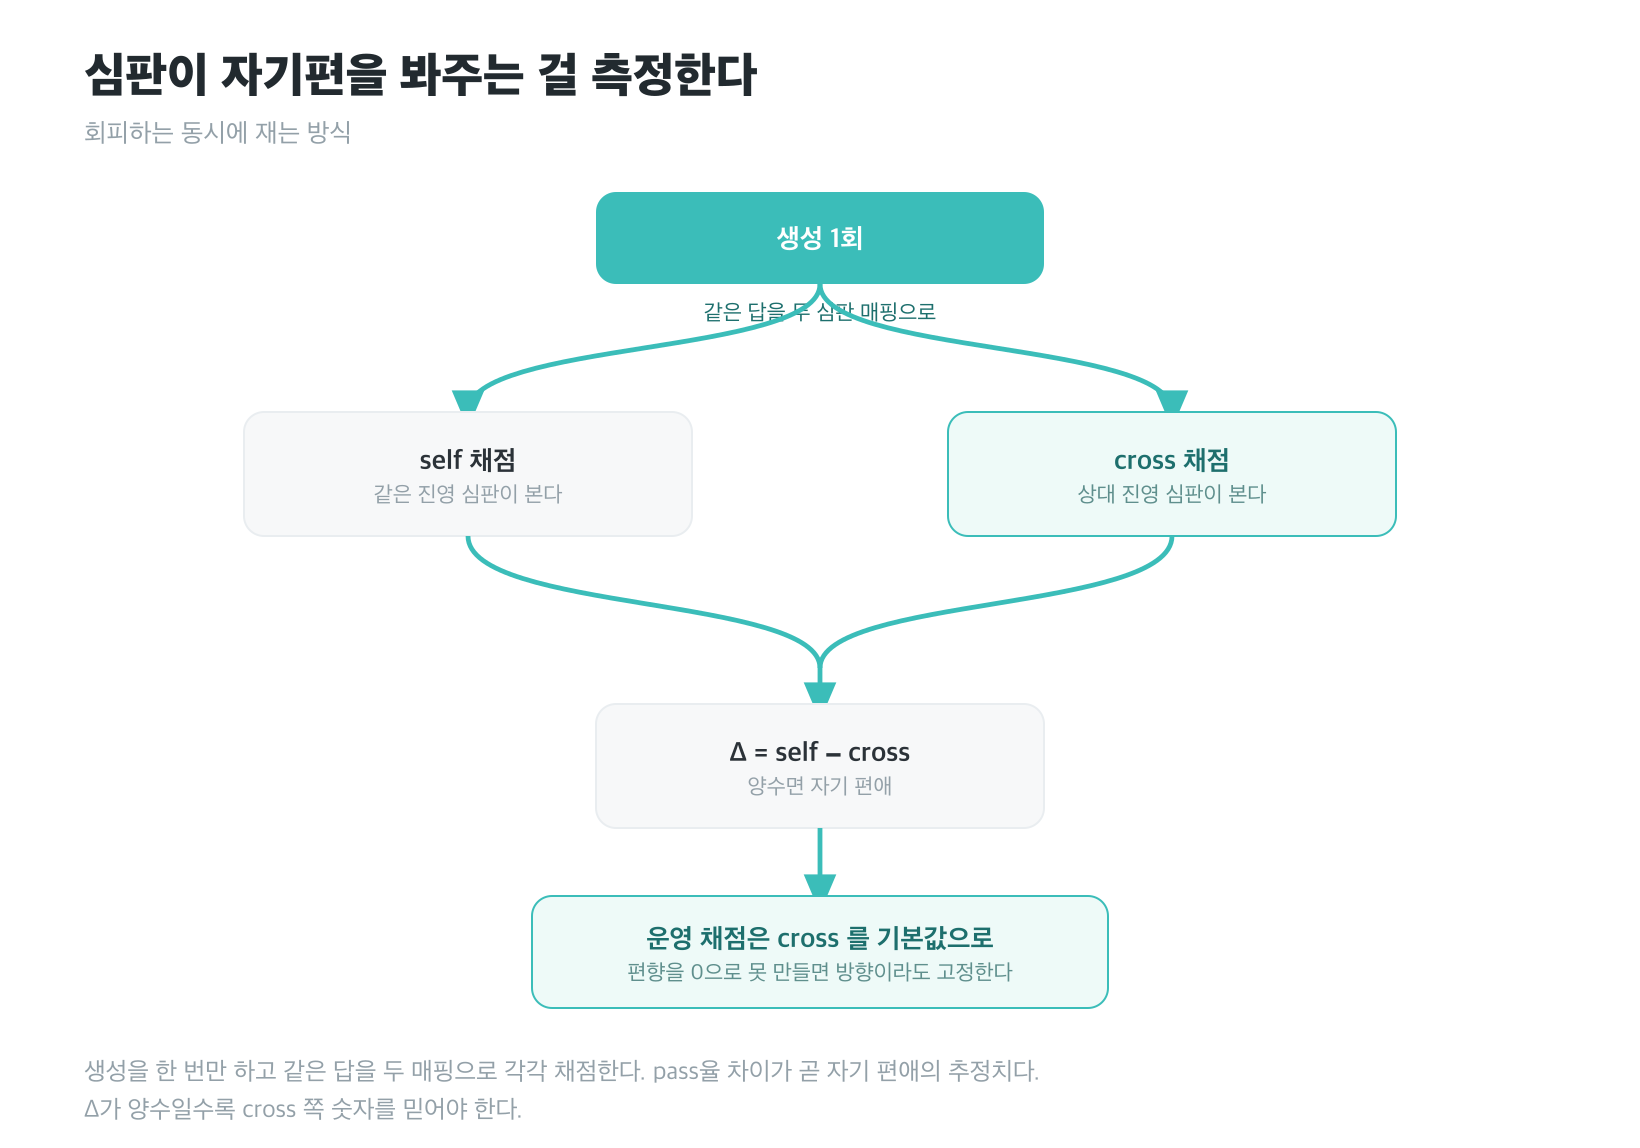
핵심은 생성을 한 번만 하고, 같은 답을 두 심판 매핑으로 각각 채점한다는 것이다(evaluate_multi). self 매핑은 각 모델의 답을 같은 진영 심판이, cross 매핑은 상대 진영 심판이 본다. self pass율 − cross pass율이 자기 편애의 추정치가 된다. Δ가 양수면 자기 진영 심판이 후하게 본 것이고, 그럴수록 cross 쪽 숫자를 믿어야 한다.
그래서 실제 운영 채점은 cross를 기본값으로 둔다. Claude의 답은 GPT 계열이, GPT의 답은 Claude 계열이 채점한다. 편향을 0으로 만들 수는 없지만, 최소한 "심판이 자기편을 봐준" 방향으로는 틀리지 않게 한다. 당시 코드 주석에 이걸 "신뢰성 렌치 1번"이라 적어뒀다(지금은 그 파일이 레거시로 밀려났고, 기본값 자체는 그대로다).
교차 채점이 늘 붙는 건 아니다. 뒤에 나오는 법령해석 갈래처럼 엔진이 답을 생성하지 않고 이미 있는 실행 기록을 채점하는 경우에는 self/cross 매핑을 만들 자리가 없다. 그쪽 숫자에는 "편향을 회피했다"를 붙이지 않는다.
한 가지는 정직하게 적어둔다. self−cross 델타를 재는 장치는 있지만, 지금 저장소에 박제된 편향 수치는 없다. 이건 "얼마다"라고 단정할 실측이 아직 없다는 뜻이고, 그래서 지어내지 않는다. 이 문서가 파는 건 숫자가 아니라 편향을 눈에 보이게 만드는 구조 다.
채점기를 채점한다, control
교차 채점으로도 남는 질문이 있다. 심판이 애초에 환각을 잡을 줄 아는가? pass율이 100%로 예뻐도, 심판이 눈을 감고 다 PASS를 주는 중이면 그 숫자는 거짓이다.
그래서 매 실행에 사람이 심은 환각(control) 을 한 케이스 꽂는다. 생성 단계를 건너뛰고, 일부러 지어낸 답을 모든 심판에게 채점시킨다. 예를 들어 CONTEXT에 없는 사실("페르시안 고양이 나비는 올해 다섯 살이고 동물병원도 다녀왔다")을 심어두면, 제대로 된 심판이라면 이걸 FAIL로 잡아야 한다. control인데 PASS가 나오면 그건 대상 모델이 아니라 심판이 고장 난 것 이고, 게이트가 그 자리에서 빌드를 깬다.
실제로 opus-4-8·gpt-5.5를 심판으로 세운 회차에서 심은 환각은 두 심판이 2/2로 모두 잡았고, 각자 "CONTEXT에 없는 품종·나이·병원 방문을 지어냈다"고 정확히 지목했다. 이게 통과해야 비로소 나머지 pass율을 믿을 자격이 생긴다. 채점기를 채점하고 나서야 채점을 믿는다.
control이 못 잡는 실패, 심판이 근거를 지어낼 때
control은 "심판이 환각을 잡을 줄 아나"를 본다. 그런데 반대 방향의 실패가 하나 더 있다. 심판이 없는 것을 있다고 하는 것.
행정 답변을 채점하는 갈래를 붙이면서 이게 실물로 나왔다. 공무원 민원회신과 AI 답변을 맞대 "공식 회신의 요점을 답변이 담았나"를 요점별로 묻는 채점인데, 한 케이스를 세 번 돌려 손으로 채점한 기대값과 맞대보니 작은 심판이 요점 대조에서 어긋났다. 답변 어디에도 방지시설·배관·공급탱크라는 말이 없는데, 세 번 모두 "담았다"고 판정했다. 답변 원문을 뒤져 확인했다. 근거로는 공식 회신 문장을 그대로 옮겨 적었다. 채점 대상이 아니라 기준에서 베껴 온 것이라, 아무것도 확인하지 않고 통과시킨 셈이다.
눈을 감고 다 통과시키는 실패가 아니다. 그건 control이 잡는다. 이건 근거를 지어내서 통과시키는 실패라 control을 멀쩡히 통과한다. 형식이 그럴듯하면 내용이 틀려도 넘어가는 쪽이고, 공공행정 문서에서는 이게 가장 위험하다.
고치는 방향으로 "확실하냐"고 심판에게 되묻는 길도 있었다. 같은 편향을 한 번 더 부르는 것이라 택하지 않았다. 대신 심판의 말을 코드가 대조할 수 있는 형태로 받는다.
- 일치나 부분으로 판정하려면
evidence에 답변에서 그대로 따온 문장을 넣어야 한다 - 채점기가 그 문장이 답변에 실제로 있는지 글자로 대조한다
- 없으면 심판이 뭐라 했든 불일치로 내린다
글자 하나까지 같기를 요구하지는 않는다. 표로 쓴 답변에서 심판이 칸을 문장으로 풀어 적는 일이 잦고, 그건 판정은 맞고 인용 표기만 어긋난 경우다. 그래서 가장 길게 이어지는 토막이 따온 문장의 60% 이상인지로 본다. 임계는 감이 아니라 실제 답변으로 재서 잡았다.
| 겹침 비율 | |
|---|---|
| 답변에서 그대로 따온 문장 | 1.00 |
| 말을 바꿔 적은 인용 | 0.74 ~ 0.88 |
| 지어낸 인용, 기준에서 옮겨 온 것 | 0.13 ~ 0.31 |
두 무리 사이가 넓게 비어 있어서 0.6이 거기 들어간다. 너무 짧은 인용은 아예 근거로 치지 않는다. "4년" 같은 조각은 어느 답변에나 있어서 글자 그대로 들어맞아도 그 요점을 담았다는 근거가 못 된다.
같은 자료를 큰 모델(sonnet)로 다시 돌리면 요점 대조 15칸이 손 채점과 그대로 맞았다. 축마다 필요한 심판 체급이 다르다는 뜻이고, 그걸 알아내는 방법이 손 채점 대조였다. 다만 한 케이스 세 실행으로 본 것이라 "작은 모델은 못 한다"로 일반화하지는 않는다.
여기서 하나 더 배웠다. 심판이 항목을 빠뜨리거나 응답 파싱이 실패하면 그 항목을 FAIL로 남긴다. PASS로 눅이면 분모가 조용히 줄어 점수가 올라간다. 그리고 이게 오진의 함정이 되는 자리가 있었다. thinking이 켜진 모델에 max_tokens를 작게 주면 사고에 전부 쓰고 텍스트를 한 글자도 내지 않는데, 그러면 모든 항목이 "판정하지 않았다"로 떨어져 겉보기에는 심판이 유난히 깐깐한 것처럼 보인다. 상한을 올려서 해결됐지만, 모델 성능 문제로 결론 낼 뻔한 자리였다.
그래서 함정 자체를 기록에 남기기로 했다. 어댑터가 판정을 돌려줄 때 파싱된 결과만 주지 않고 심판이 실제로 낸 글과 파싱이 실패한 이유를 같이 준다. 판정 행에 judge_parse_error가 붙으면 응답을 못 읽은 것이고, 비어 있는데 FAIL이면 심판이 그렇게 본 것이다. 같은 "판정하지 않았다"가 표에서 두 갈래로 갈린다. 원시 응답에는 상한(8,000자)을 뒀다. 한 번 부른 응답에서 판정 행이 여러 개 나오고 그 값이 행마다 실려서, 상한이 없으면 실행 기록 하나가 저장소 한도를 넘는다. 지금은 정제하지 않고 다 싣는다. 사유 한 줄에 따온 문장이 앞 40자만 들어가던 때는 왜 그렇게 봤는지 되짚을 방법이 아예 없었기 때문이다.
검색 계층까지, 심판이 회귀를 잡는다
reference-free 심판의 진짜 이식성은 대상 시스템의 함수 하나만 가리키면 붙는다는 데 있다. RAG에서 검색 품질을 재는 context_sufficiency 심판은 "검색된 CONTEXT만으로 이 질문에 답할 정보가 들어있나"만 본다. 직접 답을 생성하지 않고, 필요한 정보의 존재 여부만 판정한다. 청커·임베딩·파서를 바꾸면 검색되는 CONTEXT가 달라지므로, 이 지표가 그 회귀를 그대로 드러낸다.
검색 임계값을 훑어보면 심판이 실제로 회귀를 잡는 게 보인다. 임계 0.35에서는 검색이 답을 놓쳐 recall 1/2, sufficiency 2/4로 게이트 FAIL, 임계를 0.18로 낮추자 recall 2/2, sufficiency 4/4로 PASS가 됐다. 결정적 신호(recall@k, 무LLM)와 심판 신호(sufficiency)가 같은 방향으로 움직이는 게, 심판이 헛것을 보고 있지 않다는 또 하나의 방증이다.
구조화 출력 강제, 판정을 데이터로
심판의 출력이 산문이면 집계할 수 없다. 그래서 판정은 처음부터 작은 스키마로 강제한다.
passed가 있으니 pass율·게이트가 계산되고, reason이 있으니 왜 그렇게 봤는지 사람이 되짚는다. 두 프로바이더의 서로 다른 구조화 출력 방식(Claude의 스키마 파싱, OpenAI의 JSON 모드)을 같은 Verdict 타입 하나로 수렴시키기 때문에, 심판을 갈아 끼워도 하류(집계·게이트·추세)는 그대로다.
작은 강건함도 하나 심어뒀다. reason에 기본값을 둬서, 심판이 간헐적으로 근거를 빠뜨려도 파싱이 깨지며 실행 전체가 죽지 않는다. 프롬프트는 여전히 근거를 요구하되, LLM 출력 경계에서는 관대하게 받는다. "엄격하게 요구하고, 관대하게 파싱한다."
작은 표본의 정직성, Wilson CI
여기까지 오면 pass율이 예뻐 보인다. 4/4, 100%. 하지만 4개짜리 표본의 100%는 증명이 아니라 신호 다. 이걸 100%라고 적으면 거짓말에 가깝다.
그래서 pass율마다 Wilson 점수 구간(95%) 을 같이 낸다. 같은 4/4라도 Wilson CI는 대략 51%~100% 로 벌어진다. 2/2면 34%~100%, 8/8이라야 68%~100%다. 표본이 작을수록 구간이 넓다는 걸 숫자가 스스로 실토한다. "100% 통과"가 아니라 "통과했지만 표본이 이만큼 얇다"를 같은 화면에 붙여두는 것 — 이게 작은 평가셋을 정직하게 다루는 최소한이다.
이 정직함은 앞의 모든 장치와 한 줄로 이어진다. 교차 채점으로 편향을 줄이고, control로 심판을 검증하고, 구조화로 집계 가능하게 만들어도, 표본이 작으면 결론은 여전히 신호일 뿐 이다. 신뢰구간은 그 사실을 지우지 않고 화면에 남겨둔다.
Decision Log
self-preference bias를 0으로 만들 수는 없어도, 심판이 자기편을 봐주는 방향으로는 틀리지 않게 한다. Claude 답은 GPT 계열이, GPT 답은 Claude 계열이 채점하는 교차 매핑을 운영 기본값으로 뒀다.
생성은 1회, 같은 답을 self·cross 두 매핑으로 채점해 self − cross 델타를 낸다. 편향을 "조심하자"가 아니라 눈에 보이는 수치로 만든다. 다만 지금 박제된 델타 값은 없어서, 있는 척하지 않는다.
매 실행에 사람이 심은 환각을 꽂아, 심판이 그걸 FAIL로 잡는지 확인한다. control이 PASS면 대상이 아니라 심판이 고장 난 것 — 게이트가 빌드를 깬다. pass율은 이 헬스체크를 통과한 뒤에만 의미를 갖는다.
심판이 "일치"라고 하려면 답변에서 따온 문장을 함께 내야 하고, 채점기가 그 문장이 실제로 답변에 있는지 글자로 대조해 없으면 불일치로 내린다. "확실하냐"고 다시 묻는 것은 같은 편향을 한 번 더 부르는 일이다. 심판의 말을 코드가 검증할 수 있는 형태로 받는 쪽을 택했다.
둘 다 "판정하지 않았다"로 떨어지는데, 표에서 같아 보이면 모델 탓으로 오진한다. 판정마다 심판의 원시 응답과 파싱 실패 사유를 함께 싣고, 지금은 정제하지 않는다. 모양은 화면을 보고 줄인다.
4/4는 51%~100%다. pass율마다 Wilson 95% 구간을 붙여, "증명"과 "신호"를 구분한다. 표본이 얇다는 사실을 숫자로 같이 남긴다.
배운 것
LLM-as-judge의 어려운 부분은 "LLM에게 채점을 시키는 것"이 아니다. 그건 프롬프트 한 장이면 된다. 어려운 건 그 채점을 믿을 근거를 만드는 것 이다. 심판은 자기편을 편애하고, 스타일에 홀리고, 때로는 눈을 감고 다 통과시키고, 때로는 근거를 지어내 통과시킨다. 그래서 교차로 채점해 편향을 줄이고, 심은 환각으로 심판을 먼저 검증하고, 심판이 댄 근거를 코드로 대조하고, 판정을 구조화해 집계 가능하게 만들고, 신뢰구간으로 표본의 얇음을 실토하게 한다.
장치를 하나 붙일 때마다 심판에게 맡기는 몫이 줄었다는 게 지금 가장 또렷하게 남은 감각이다. 처음에는 심판이 PASS/FAIL을 정했다. 지금은 심판이 "여기 근거가 있다"를 내고 계산이 그걸 확인한다. 결정적으로 셀 수 있는 것은 아예 심판에게 묻지 않는다. 믿을 수 있는 채점기는 더 똑똑한 심판이 아니라 심판이 틀릴 수 있는 자리를 줄인 구조 쪽에서 나왔다.
그리고 마지막 정직함 하나. 이 모든 장치를 붙여도 표본이 작으면 결론은 증명이 아니라 신호다. 4개를 통과했다는 건 "아직 안 깨졌다"이지 "옳다"가 아니다. LLM으로 채점한다는 기법의 값은 완벽한 점수를 주는 데 있지 않고, 틀렸을 때 그걸 빨리·정직하게 드러내는 데 있다.