채팅창에 PDF를 하나 끌어다 놓았다. AI가 내용을 읽고 요약해 주길 기대했다. 돌아온 건 422였다.
파일은 서버 문턱도 못 넘었다. AI가 읽고 말고 할 것도 없이 업로드 자체가 깨졌다.
그날 이 파일 하나를 AI 앞까지 밀어 넣는 데 네 군데서 막혔다. 업로드, 타입 판별, 텍스트 추출, 그리고 LLM에 먹이는 자리. 아래는 파이프라인 순서대로 적었지만, 실제로 그날 고친 순서는 이렇게 깔끔하지 않았다. 뒤쪽 관문을 먼저 뜯고 앞으로 돌아온 것도 있다.
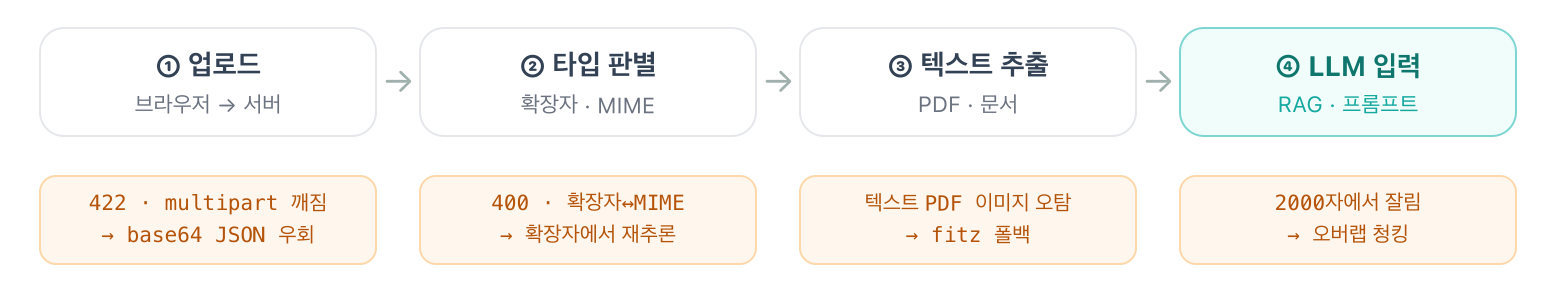
첫 번째 관문: 업로드가 서버에서 깨졌다
422는 서버가 요청 본문을 이해하지 못했다는 신호다. 파일은 보통 multipart/form-data로 올라간다. 브라우저가 파일을 조각내 경계 문자열로 감싸 보내고, 서버가 그걸 다시 조립한다. 그 조립이 서버에서 어긋났다.
원인을 끝까지 파지는 않았다. 경계 파싱이 어긋난 건지 필드 이름이 안 맞은 건지, 정확히 어디서 깨졌는지는 확인하지 않았다. 파는 대신 파일 자체를 base64 문자열로 바꿔 평범한 JSON 본문에 실어 보냈다.
JSON은 이미 모든 계층이 다루던 형식이다. 특별한 파싱도, 경계 문자열도 없다. base64 JSON으로 보내자 422가 사라졌다.
막힌 정문을 붙들지 않고, 이미 열려 있는 옆문으로 돌아갔다.
두 번째 관문: 서버가 파일 종류를 잘못 알았다
파일이 도착하기 시작했다. 이번엔 400이 떴다.
서버는 파일이 무슨 타입인지 보고 처리 방식을 정한다. 그 판단을 클라이언트가 보내준 MIME 타입에 맡기고 있었다. 문제는 확장자는 문서인데 MIME은 엉뚱하게 찍혀 오는 경우였다. 브라우저나 OS에 따라 docx 같은 문서가 일반 바이너리로 붙거나, 확장자와 Content-Type이 서로 다른 말을 했다.
서버는 그 불일치를 보고 "처리 못 하는 타입"이라며 400을 냈다. 그런데 그 400에는 사유가 없었다. 나는 빈 400을 앞에 두고 왜 막혔는지 감으로 찍고 있었다.
먼저 로그부터 심었다. 400을 낼 때 어떤 확장자에 어떤 MIME이 왔고 왜 거절했는지를 찍게 했다. 그러자 확장자와 Content-Type이 서로 다른 말을 하는 게 눈에 보였다. 그다음은 간단했다. 클라이언트가 보내준 MIME을 믿는 대신 확장자에서 타입을 다시 추론했다.
빈 400 대신, 어떤 확장자에 어떤 MIME이 왔는지 찍힌 로그.
빈 400을 노려보며 감으로 찍던 것보다, 로그 한 줄이 빨랐다.
세 번째 관문: 텍스트 PDF를 이미지로 오해했다
타입도 맞췄다. 이제 PDF에서 글자를 뽑을 차례다.
그런데 멀쩡한 텍스트 PDF가 이미지로 분류됐다. 글자가 데이터로 들어 있어 바로 긁으면 되는 파일인데, 스캔한 종이처럼 취급된 것이다. 판별기가 왜 그렇게 봤는지는 파고들지 않았다. 이미지 처리기로 넘어가니 제대로 된 텍스트가 안 나왔다.
fitz(PyMuPDF)로 폴백을 붙였다. 분류를 믿기 전에 일단 텍스트 추출을 시도해 본다. 글자가 나오면 텍스트 PDF로 처리한다. 판별기의 선입견 대신, 실제로 긁어보고 그 결과로 판단하게 바꾼 것이다.
네 번째 관문: 겨우 뽑은 텍스트가 2000자에서 잘렸다
글자까지 뽑았다. 마지막 관문은 이 텍스트를 LLM에 먹이는 자리였다.
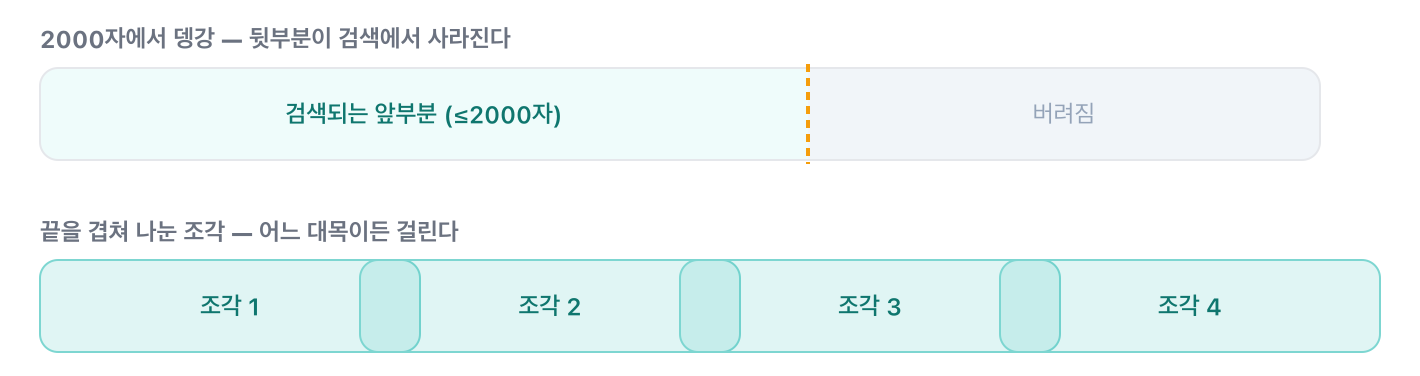
여기서 텍스트가 2000자에서 잘려 나갔다. 긴 문서를 붙이면 앞머리 2000자만 AI에 닿고 나머지는 통째로 버려졌다. 요약을 시키면 문서 뒷부분은 존재하지도 않는 것처럼 굴었다.
2000자 truncate를 걷어내고 오버랩 청킹을 넣었다. 문서를 자르되, 조각들이 서로 끝을 겹치게 나눈다. 겹치는 이유는 문장이 조각 경계에서 끊기면 의미도 끊기기 때문이다. 앞 조각의 꼬리를 뒤 조각의 머리에 다시 넣어 두면, 경계에 걸친 문맥이 어느 한쪽에는 온전히 남는다.
순서대로 겪은 게 아니었다
위에 네 관문을 파이프라인 순서로 늘어놨지만, 커밋 시각을 보면 그날 실제 순서는 뒤죽박죽이다. 2000자 잘림(네 번째 관문)을 18시 49분에 먼저 걷어냈고, MIME 400(두 번째 관문)은 한 시간 뒤인 19시 39분에야 손댔다. 파이프라인 끝에 있는 관문을 앞쪽 관문보다 먼저 고친 셈이다.
네 개로 딱 떨어지지도 않았다. 텍스트를 LLM에 먹이고 나서도, 모델이 첨부를 그냥 읽는 대신 엉뚱하게 도구를 호출하는 걸 두 번 더 막아야 했다. 큰 PDF가 튕기길래 첨부 크기 상한을 10MB에서 30MB로 올린 것도 그날이다. 글로 정리하니 관문이 네 개지만, 그날 화면 앞에서는 그냥 계속 뭔가 안 됐다.
그래도 하루를 통과하며 제일 도움이 된 건 영리한 우회가 아니라 두 번째 관문에서 로그를 심은 순간이었다. 빈 400을 노려보길 멈추고 서버가 왜 거절하는지 눈으로 보기 시작하자 나머지가 풀렸다. 파일 파이프라인은 계층마다 남이 보내준 걸 그대로 믿는 구조다. 각 계층이 무엇을 받았고 왜 거절했는지 찍어두지 않으면, 어디서 깨졌는지 감으로 찍게 된다.
파일 하나 붙이는 기능은 화면상 버튼 하나다. 그 버튼 뒤에서 하루가 이렇게 시끄러울 줄은 몰랐다.